Anthropic vient de pousser un démo qui mérite qu’on s’arrête : Claude Code, piloté par 16 sous-agents en parallèle, a construit un compilateur C fonctionnel de 100 000 lignes. Pas un script de 200 lignes pour automatiser des fichiers CSV. Un compilateur. Complet. Ce n’est pas du tout la même chose. Ce que tu vas apprendre :
- Ce qu’Anthropic a concrètement fait avec 16 agents simultanés
- Pourquoi un compilateur C est un test de complexité logicielle particulièrement dur
- Ce que ça change (et ne change pas encore) pour tes workflows de développement
- Les questions de supervision et de coût que ça soulève
- Ce qu’on retient de ce pivot vers l’IA agentique en 2026
En bref
Soyons clairs. Anthropic n’a pas juste généré du code. Ils ont orchestré une architecture multi-agents où Claude Code supervisait 16 sous-agents travaillant simultanément sur différentes parties d’un même projet logiciel massif. Le résultat final est fonctionnel et compile réellement. 5 choses à savoir :
- 100 000 lignes de C ont été produites par des agents autonomes coordonnés par Claude Code, pas par un humain qui a révisé ligne par ligne.
- 16 sous-agents en parallèle ont travaillé simultanément sur des modules distincts, puis Claude Code a intégré leurs outputs en un codebase cohérent.
- Un compilateur C n’est pas un projet trivial : c’est un des logiciels les plus exigeants à écrire côté cohérence interne, gestion d’état et interdépendances entre modules.
- Le coût de cette opération est réel : Claude Opus 4.6 facture $15 USD/million de tokens en entrée et $75 USD/million de tokens en sortie (environ 20 $ CAD et 100 $ CAD respectivement). Une session multi-agents de cette envergure consomme beaucoup.
- **Ce démo signale un changement de ** : on passe de l’autocomplétion intelligente à la délégation de projets entiers à des agents autonomes.
Dans le détail
Ce qu’Anthropic a fait exactement
Anthropic a utilisé Claude Code pour orchestrer une session multi-agents sur un projet de compilation C de grande envergure. L’agent principal décomposait le projet en sous-tâches discrètes, assignait chacune à un sous-agent distinct, puis réintégrait les outputs en maintenant la cohérence globale du codebase. Ce n’est pas un agent qui écrit tout en séquence et qui espère que ça marche à la fin. C’est une architecture où des modules distincts (lexer, parser, générateur de code intermédiaire, optimiseur, back-end, etc.) sont développés en parallèle, avec un orchestrateur qui gère les interfaces et les dépendances.
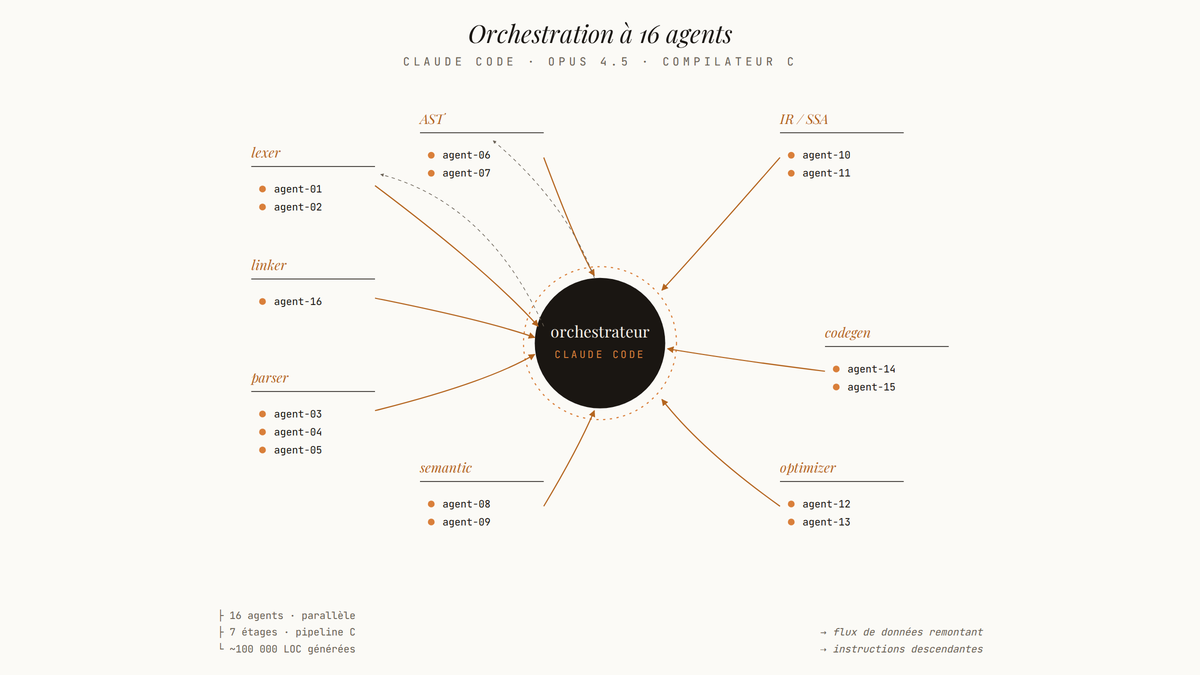
Le résultat final : 100 000 lignes de code C, fonctionnelles. Le compilateur compile réellement. Ce n’est pas du code mort ou un prototype brisé généré pour la galerie.
Comment fonctionnent les 16 sous-agents en parallèle
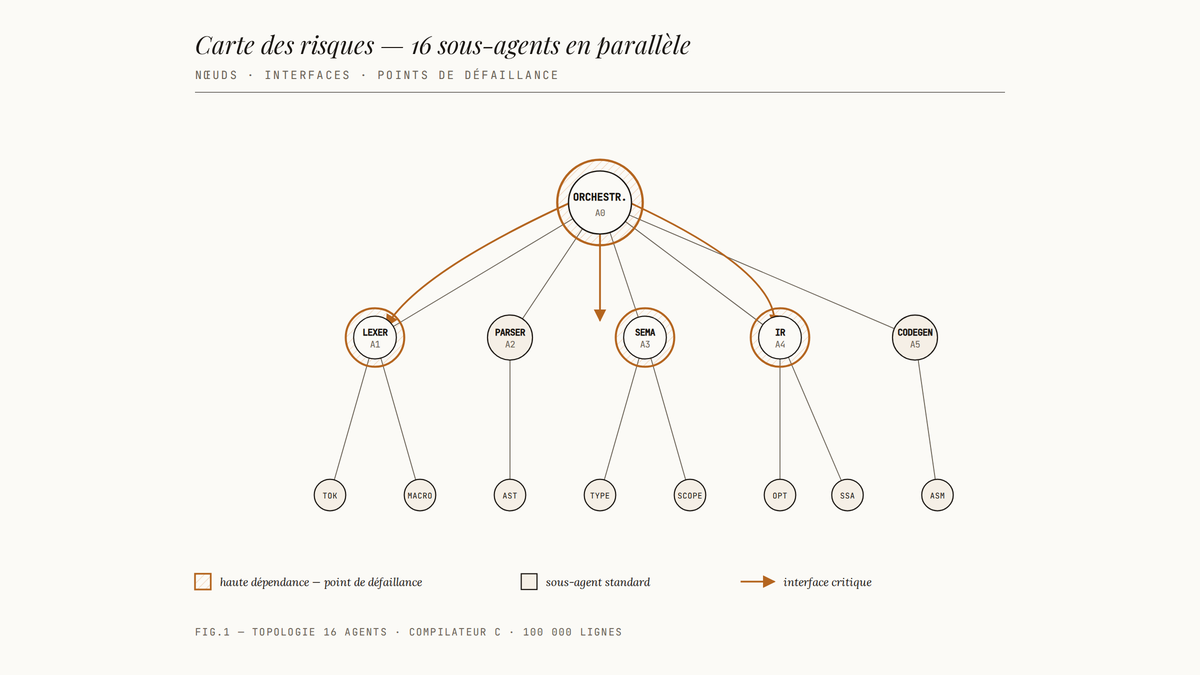
L’approche séquentielle classique d’un agent unique a une limite physique évidente : il traite une chose à la fois. Si chaque module prend du temps à générer, à tester et à corriger, l’accumulation devient prohibitive pour un projet de cette taille. Le parallélisme change cette dynamique. Les 16 sous-agents travaillent simultanément sur des portions distinctes du projet. L’orchestrateur maintient un registre des interfaces entre modules pour éviter les conflits et les régressions.
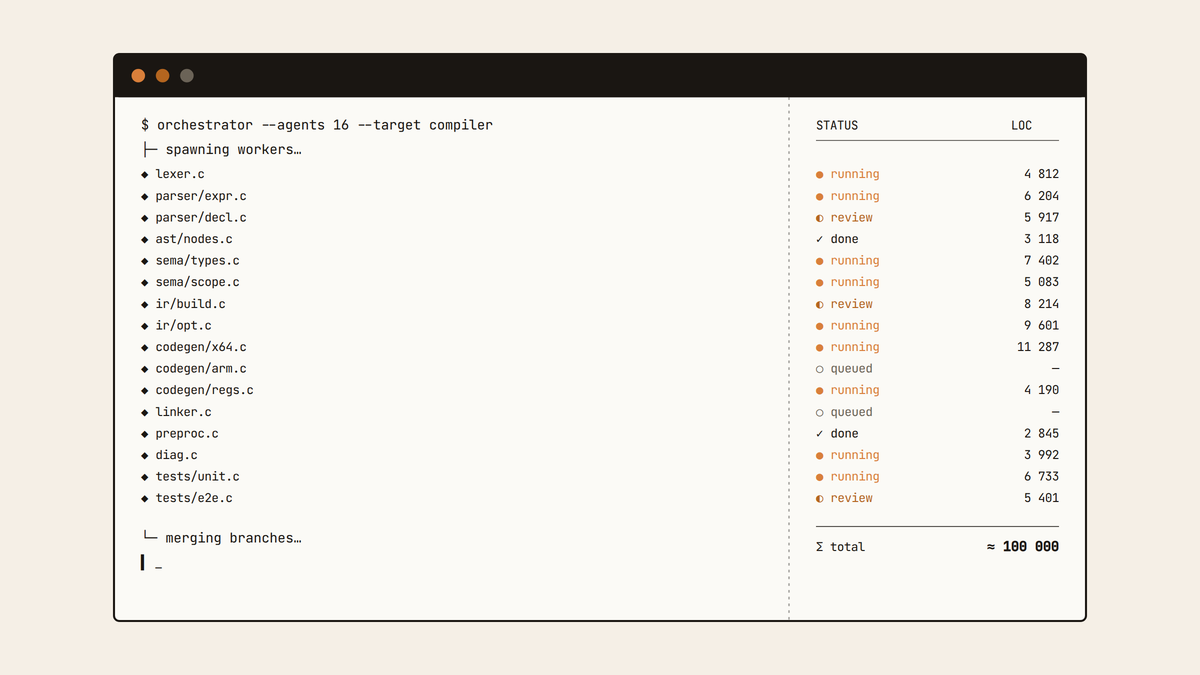
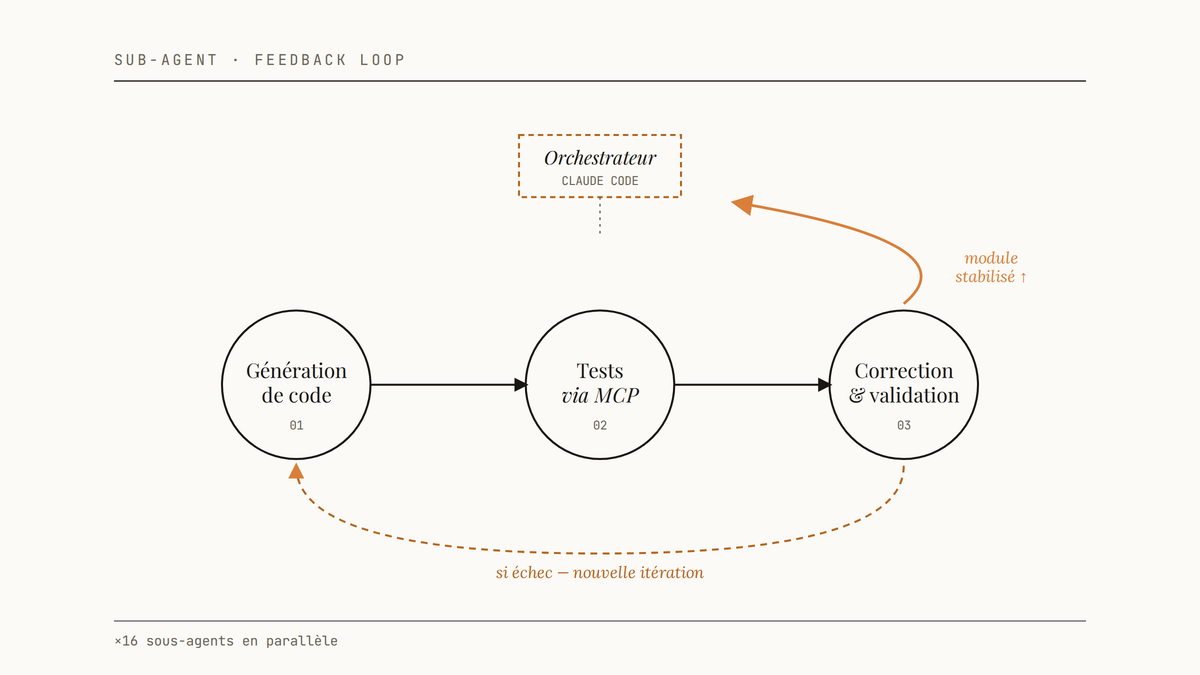
La vraie difficulté n’est pas de générer du code dans des silos parallèles. C’est de maintenir une cohérence architecturale quand plusieurs agents modifient des composants interdépendants en même temps. C’est là que Claude Code est testé pour vrai. Claude Code supporte nativement le protocole MCP (Model Context Protocol), ce qui lui permet de brancher des outils externes comme des exécuteurs de tests, des linters et des validateurs directement dans la boucle d’itération des agents. Chaque sous-agent peut donc tester son propre module en temps réel, pas juste écrire du code dans le vide.
Pourquoi 100 000 lignes de C, c’est un test sérieux
Un script Python de quelques centaines de lignes, c’est facile à générer. Même un outil web full-stack bien structuré. Mais un compilateur C, c’est une autre catégorie de difficulté. Un compilateur doit gérer une grammaire formelle, des arbres syntaxiques, de l’analyse sémantique, de la gestion de types, de l’optimisation de code intermédiaire et un back-end qui produit du code machine valide. Chaque étape est une interface contrat avec les étapes suivantes. Si une représentation intermédiaire change de format, tout le pipeline casse.
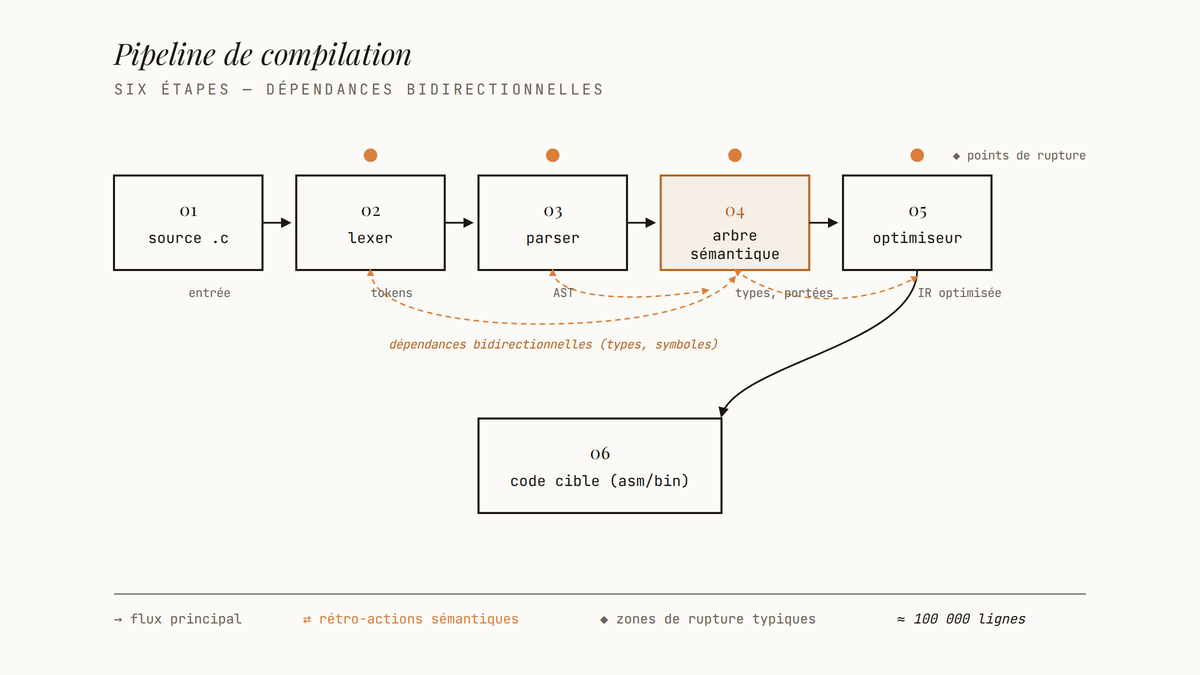
C’est précisément pour ça que ce démo est techniquement significatif. Si les agents peuvent maintenir la cohérence sur un projet avec ce niveau d’interdépendances internes, ça valide l’architecture pour une classe large de projets logiciels complexes.
Test de cohérence réelle : un compilateur C qui ne compile pas réellement n’a aucune valeur de démonstration. Le fait qu’Anthropic affirme un résultat fonctionnel place ce démo au-dessus du bruit habituel des démos IA soigneusement scénarisées.
Ce que ça change pour les équipes de développement
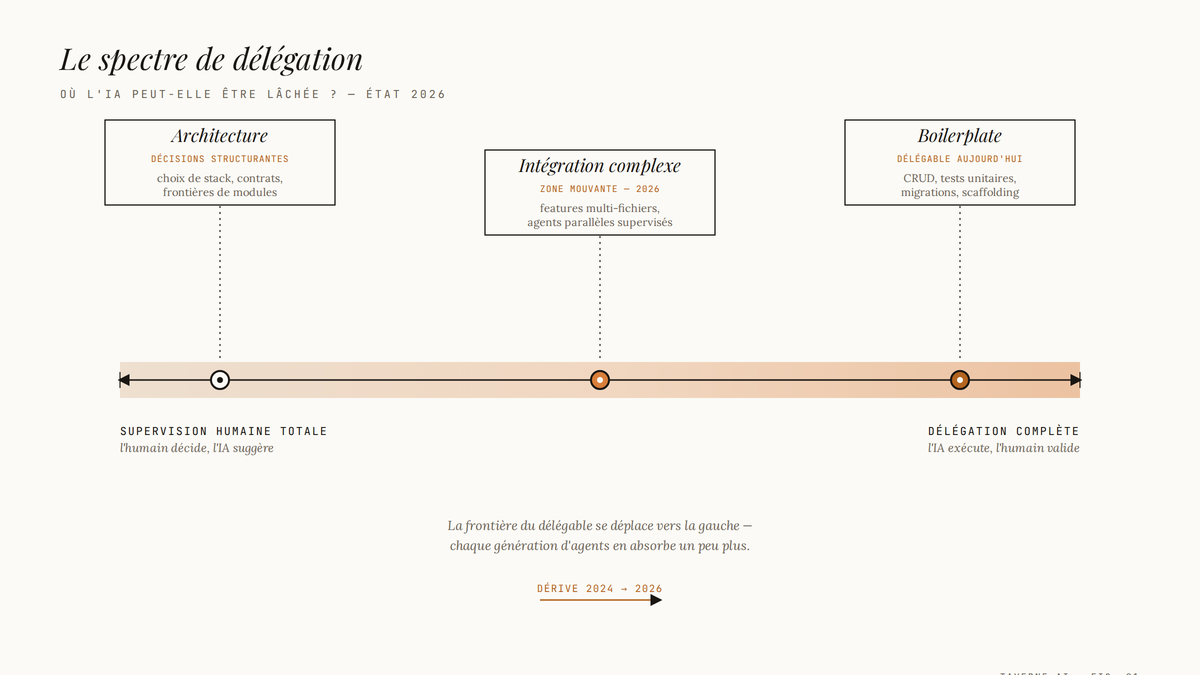
Là, écoute. L’impact le plus immédiat n’est pas « les développeurs vont perdre leur emploi ». C’est beaucoup plus précis que ça. Ce que cette capacité change, c’est la réponse à la question : « Qu’est-ce qu’on peut déléguer entièrement à un agent vs. ce qui nécessite encore une supervision humaine serrée? » La réponse se déplace concrètement vers le haut de la chaîne de valeur.
| Tâche | Avant (agent séquentiel) | Maintenant (multi-agents parallèles) |
|---|---|---|
| Boilerplate et scaffolding | Délégable | Délégable plus vite |
| Modules isolés | Délégable avec révision | Délégable avec tests automatisés |
| Intégration de composants complexes | Supervision humaine forte | Supervision humaine réduite |
| Architecture globale | Humain | Humain (pour l'instant) |
| Validation finale | Humain | Humain obligatoire |
Les plans Claude Code commencent à 20 $US/mois (17 $US/mois en facturation annuelle) pour le plan Pro. Les plans Max montent à 100 $US/mois et 200 $US/mois selon l’usage. L’accès API est gratuit, mais les tokens sont facturés : Opus 4.6 coûte $15 USD par million de tokens en entrée et $75 USD par million en sortie. Pour une session multi-agents de grande envergure, la note peut devenir significative.
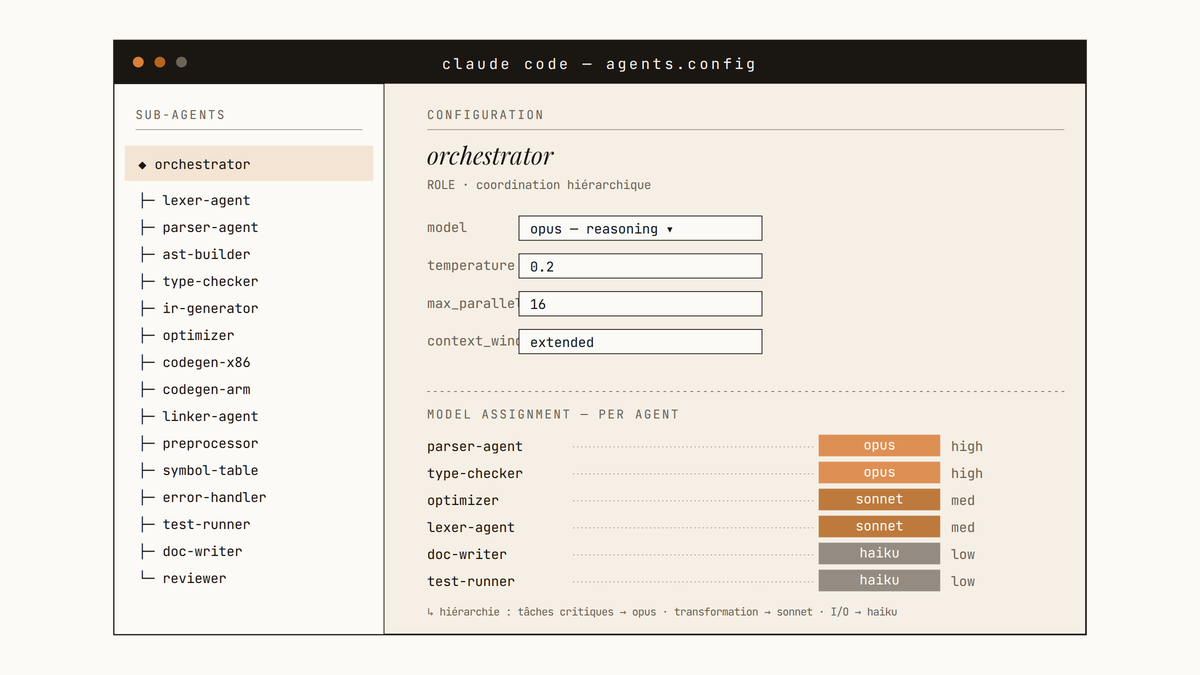
La question du choix de modèle devient donc stratégique. Claude Sonnet 4 coûte environ 1/5 du coût d’Opus 4.6. Pour des sous-tâches bien définies et peu ambiguës (générer du code boilerplate, écrire des tests unitaires simples), utiliser Opus 4.6 sur tous les agents serait probablement inefficace. L’architecture multi-agents ouvre la porte à des stratégies de mixing : Opus pour l’orchestration et les décisions architecturales, Sonnet pour les modules plus mécaniques.
Les limites et questions qui restent ouvertes
OK, voici ce qui n’a pas été résolu par ce démo et qui mérite d’être nommé clairement. La supervision humaine n’a pas disparu. 100 000 lignes de code générées sans aucune révision humaine intermédiaire, c’est techniquement impressionnant. C’est aussi une recette pour des vulnérabilités, des dépendances problématiques et des comportements inattendus en production. Un compilateur qui « fonctionne » dans un sens étroit peut quand même avoir des cas limites non gérés, une sécurité mémoire défaillante ou des comportements non déterministes. La reproductibilité est une question ouverte. Ce démo a fonctionné. Est-ce que ça fonctionne de façon fiable à chaque essai? L’architecture multi-agents ajoute des points de défaillance. Si un sous-agent produit un module avec une interface qui dérive légèrement des specs, l’orchestrateur peut intégrer silencieusement quelque chose de cassé. Les tests automatisés via MCP atténuent ça, mais n’éliminent pas le risque.
Le coût d’orchestration reste opaque. Une session multi-agents de cette ampleur consomme des tokens à chaque étape : contexte de l’orchestrateur, contexte de chaque sous-agent, résultats de tests, révisions itératives. Sans une décomposition détaillée du coût total de ce démo, il est difficile d’évaluer si c’est économiquement viable pour une équipe qui n’est pas Anthropic. L’intégration dans des pipelines réels reste à valider. Produire un compilateur dans un contexte de démo contrôlé est différent de s’intégrer dans un monorepo actif avec des CI/CD existants, des conventions d’équipe, des systèmes de PR et des contraintes de sécurité. Le démo valide la capacité, pas encore le workflow de production. Le marché IA agentique est projeté à passer de 7,8 milliards à 52 milliards USD d’ici 2030. La pression commerciale pour déployer ces agents en production va être forte, probablement plus vite que la maturité opérationnelle de l’écosystème autour.
Qui est touché
Ce qu’on retient pour 2026
Le démo d’Anthropic n’est pas un artefact isolé. C’est un signal dans un contexte plus large. D’ici la fin 2026, environ 40% des applications entreprise devraient embarquer des capacités IA selon les projections actuelles. La question n’est plus « est-ce que l’IA peut écrire du code? » La question est : « à quel niveau d’abstraction l’humain doit-il intervenir et comment valider ce qu’il reçoit? »
Ce qui change concrètement pour les équipes de développement en 2026 :
- La définition d’une tâche délégable monte en complexité. Ce qui nécessitait un développeur senior pour décomposer et estimer devient potentiellement délégable à un orchestrateur, avec le senior qui valide l’architecture, pas l’implémentation.
- Les compétences de prompt engineering pour agents vont devenir critiques. Savoir écrire de bonnes spécifications d’interface entre modules, c’est maintenant une compétence qui amplifie directement la capacité de tes agents.
- La revue de code change de nature. Au lieu de lire ligne par ligne, tu valides des comportements, des tests, des cas limites. La revue devient plus fonctionnelle et moins syntaxique.
- Le coût est une variable de design. Avec Opus 4.6 à $15/$75 USD par million de tokens en entrée/sortie, l’architecture de tes agents (quels modèles pour quelles tâches) devient une décision économique autant que technique.
Le signal le plus important du démo d’Anthropic n’est pas les 100 000 lignes. C’est la démonstration que la coordination entre agents peut maintenir une cohérence architecturale sur un projet logiciel réel et non trivial. C’est le verrou qui était supposé tenir encore quelques années. Il a cédé.
Pour les équipes de développement, la prochaine étape n’est pas d’attendre que les outils soient parfaits. C’est de commencer à cartographier quelles parties de leur workflow actuel sont des bonnes candidates à la délégation agentique, et de construire les tests et les validations qui permettront de faire confiance aux outputs. La supervision humaine reste obligatoire. Mais son périmètre se déplace. Et les équipes qui comprennent où le placer vont avoir un avantage structurel sur celles qui attendent que quelqu’un d’autre décide à leur place. Pas plus compliqué que ça.
Ce qu’on retient : Claude Code avec des agents parallèles peut produire des logiciels complexes fonctionnels à une échelle qui dépasse ce qu’un agent séquentiel pourrait faire dans un délai raisonnable. Le compilateur C de 100 000 lignes est une démonstration technique sérieuse, pas un tour de passe-passe. Les questions de coût, de supervision et d’intégration en production restent ouvertes. Mais le cap a été franchi. Prochaine étape concrète : si tu utilises déjà Claude Code sur le plan Pro (20 $US/mois), commence à expérimenter avec des sessions d’orchestration simples sur tes propres projets. Pas pour remplacer ta revue de code, mais pour comprendre où tes agents excellent et où ils ont besoin de tes yeux.
Check tes courriels.
Lien à cliquer pour confirmer ton abonnement.
Texte par David Cyr