Cloudflare OS : un système d’exploitation IA open source pour l’infrastructure des entreprises
Cloudflare vient de mettre sur GitHub un projet qu’ils appellent Cloudflare OS. Le nom est ambitieux, le positionnement aussi : une couche d’infrastructure IA standardisée, open source, pensée pour les entreprises qui veulent déployer des agents ou des pipelines IA sans partir de zéro à chaque fois. La question évidente : est-ce que c’est vraiment utile, ou c’est du branding d’infrastructure sur du vide? Ce que tu vas apprendre :
- Ce que Cloudflare OS fait concrètement (et ce que le nom ne fait pas)
- Pourquoi Cloudflare mise sur l’open source pour ce type de projet
- À qui ça s’adresse dans une organisation technique
- Ce qu’on trouve réellement dans le dépôt GitHub
- Les questions légitimes qui restent sans réponse
C’est quoi Cloudflare OS, exactement
Le nom « OS » est trompeur si tu t’attends à un système d’exploitation au sens classique. Ce n’est pas un remplacement de Linux. Ce n’est pas un hyperviseur. Ce n’est pas un kernel. Cloudflare OS est plutôt une couche d’abstraction opérationnelle : un ensemble de composants, de conventions et d’outillage pour que les équipes techniques puissent assembler une infrastructure IA d’entreprise de façon cohérente. L’idée derrière le nom « OS », c’est que les agents IA ont besoin d’un environnement standardisé pour s’exécuter, exactement comme une application a besoin d’un système d’exploitation sous-jacent pour gérer la mémoire, les entrées-sorties, le réseau.
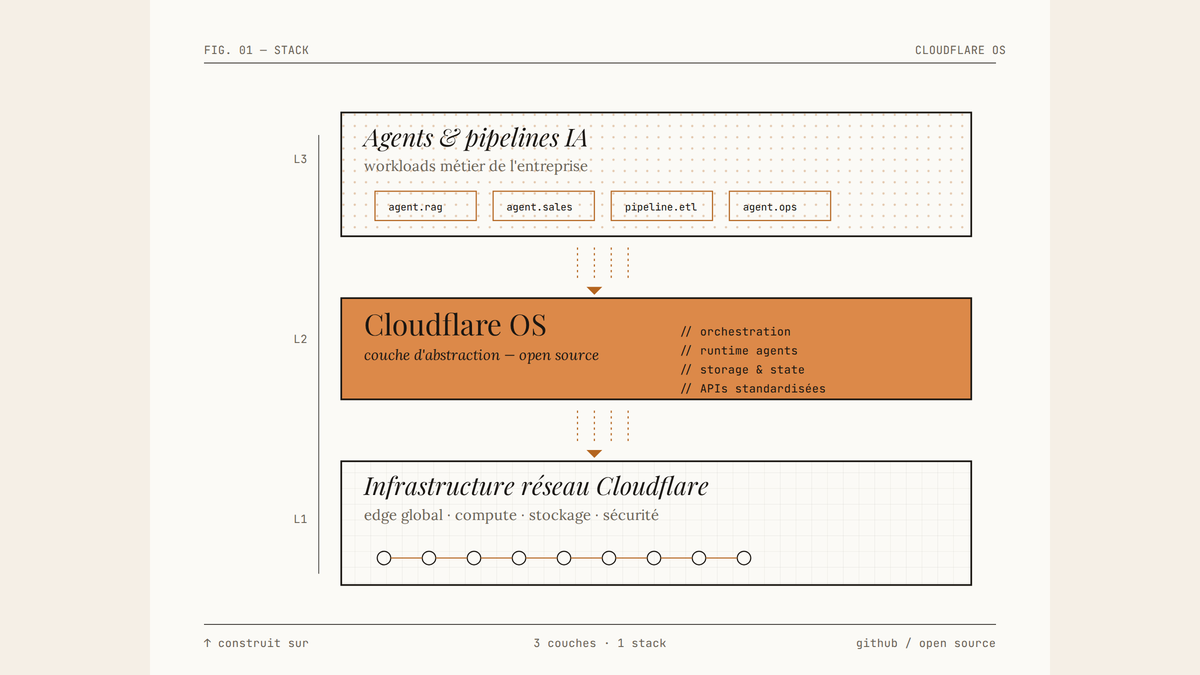
Le projet part d’un constat que n’importe quelle équipe technique qui a déployé des agents IA en production reconnaît : chaque organisation réinvente les mêmes briques. Gestion des clés API, routage des requêtes entre modèles, journalisation, contrôle d’accès, observabilité. Cloudflare OS veut standardiser tout ça.
Ce que le projet propose techniquement
Le dépôt GitHub contient plusieurs modules distincts. On y trouve des composants pour la gestion des identités et des accès dans un contexte multi-agents, des abstractions pour le routage entre différents fournisseurs de modèles, et des patterns pour la journalisation structurée des appels IA.
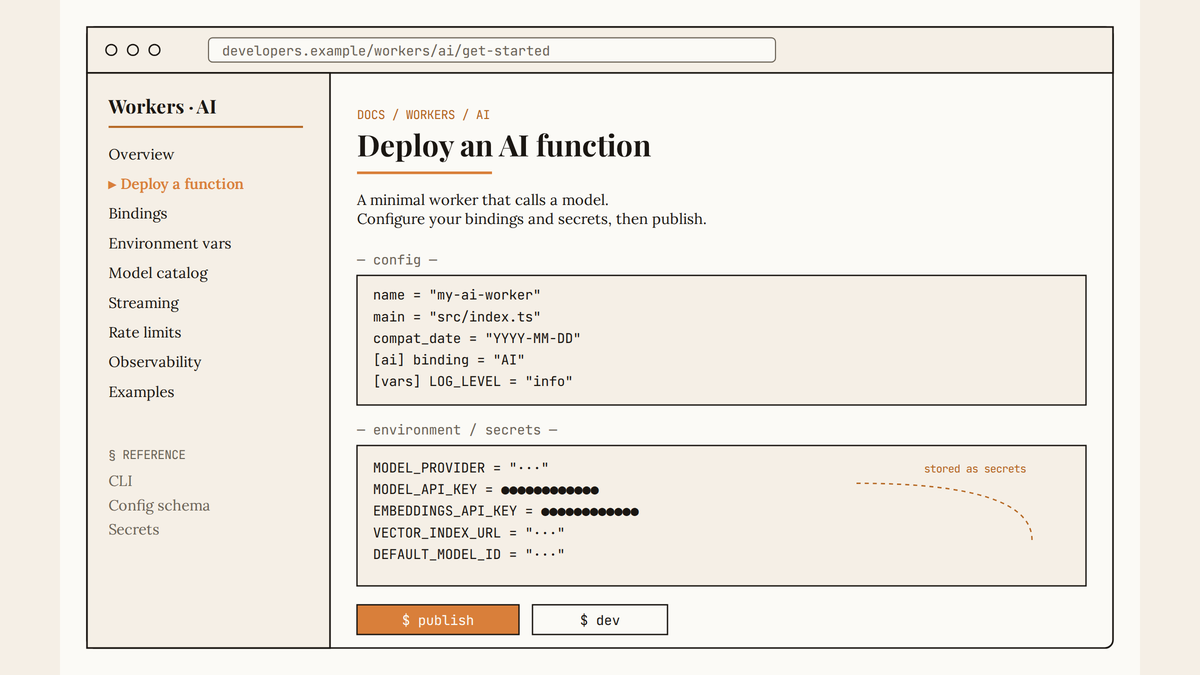
Le projet s’appuie sur l’écosystème Cloudflare Workers. Si tu ne connais pas Workers : c’est l’environnement serverless de Cloudflare qui exécute du code JavaScript ou TypeScript à la périphérie du réseau, dans leurs datacentres répartis globalement. L’avantage pour l’IA d’entreprise, c’est la latence réduite et la proximité géographique des données.
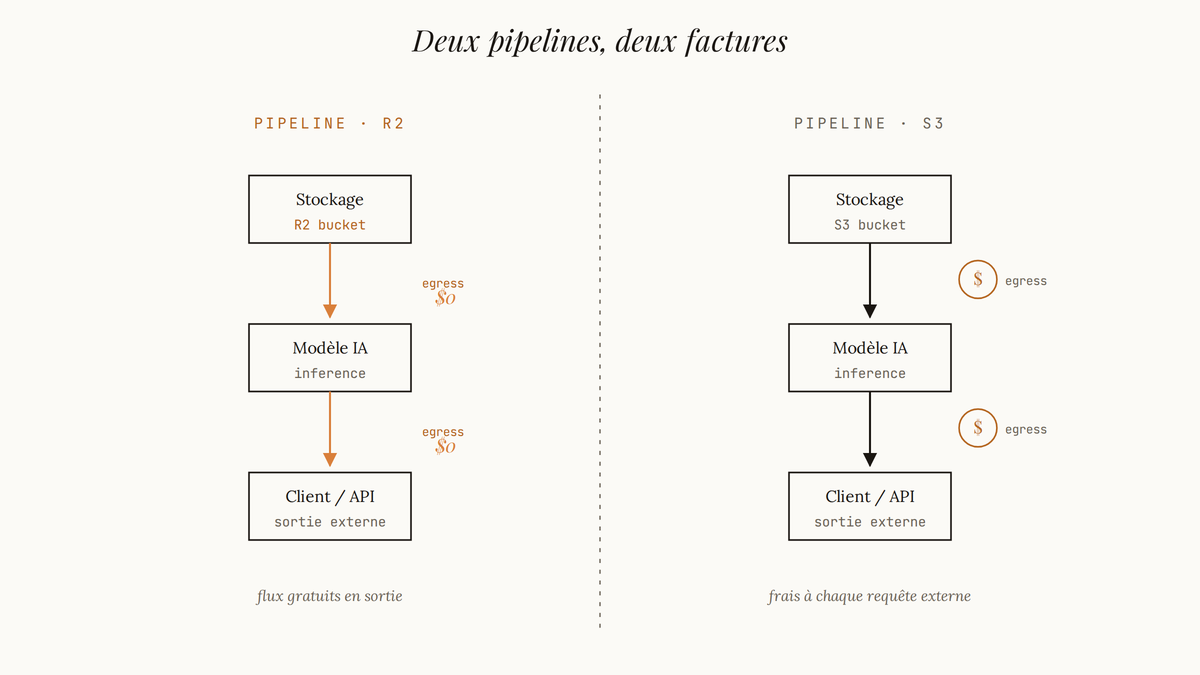
À noter : Cloudflare OS n’est pas une API propriétaire fermée que tu consommes. C’est du code que tu déploies toi-même, que tu peux modifier et que tu contrôles entièrement dans ton environnement. C’est là que l’open source change la donne concrètement. Le projet intègre aussi des composants qui interagissent avec d’autres services Cloudflare, comme R2 pour le stockage. Un avantage tangible de R2 dans ce contexte : Cloudflare ne facture pas de frais de sortie sur les données stockées dans R2, contrairement à AWS S3. Pour un pipeline IA qui lit et écrit des volumes importants de données (embeddings, contextes, logs), c’est une différence de coûts réelle à long terme.
L’architecture favorise une approche « composable » : tu prends les modules dont tu as besoin, tu laisses ceux qui ne s’appliquent pas à ton contexte. Ce n’est pas un framework monolithique où tu adoptes tout ou rien.
Pourquoi Cloudflare mise sur l’open source pour ce projet
Cloudflare a été fondé en 2009 par Matthew Prince, Lee Holloway et Michelle Zatlyn. Depuis le début, la philosophie de l’entreprise s’est souvent appuyée sur la transparence technique pour bâtir la confiance. Le plan gratuit de Cloudflare, qui inclut DNS, CDN, SSL et protection DDoS sans limite de requêtes, illustre cette approche : donne accès à de l’infrastructure solide, et les organisations qui ont des besoins sérieux finiront par monter en gamme. La logique open source pour Cloudflare OS suit le même modèle. Les entreprises sérieuses en matière d’IA ne vont pas déployer une infrastructure critique sur du code qu’elles ne peuvent pas auditer. En mettant le projet sur GitHub, Cloudflare permet aux équipes de sécurité internes d’examiner ce qu’elles exécutent réellement, pas seulement ce qu’un fournisseur affirme qu’elles exécutent.
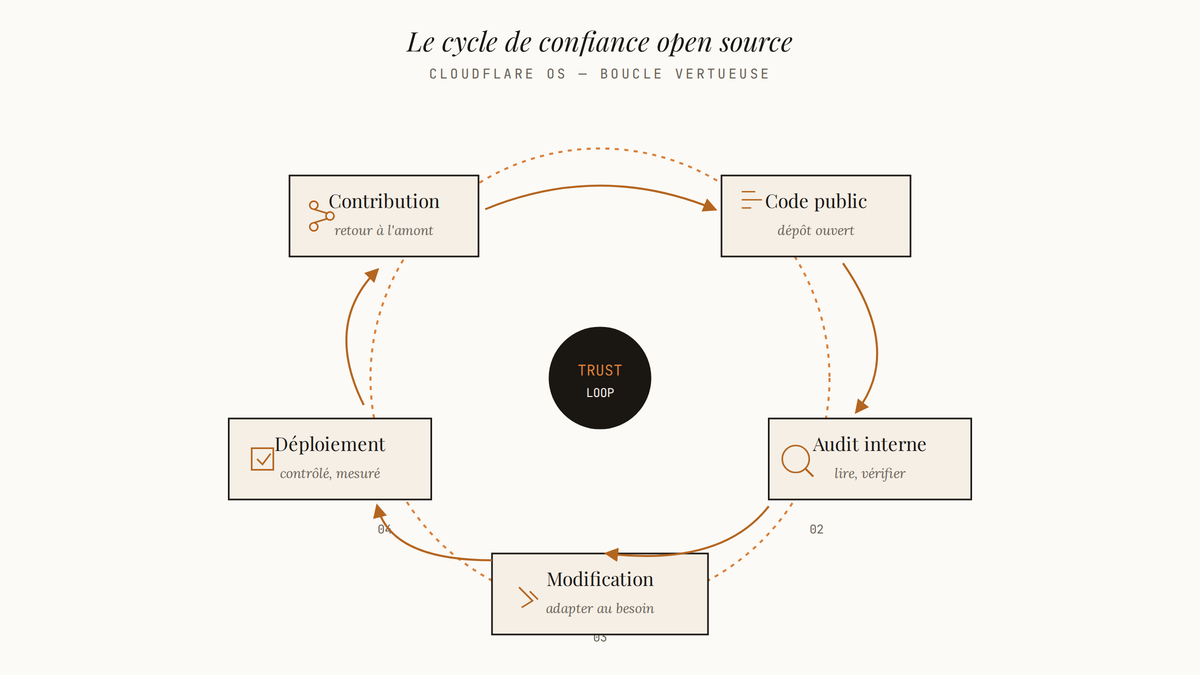
Il y a aussi un angle stratégique évident. Un projet open source attire des contributions, des intégrations tierces et une adoption organique que le marketing payant ne peut pas acheter. Si Cloudflare OS devient un standard de facto pour l’infrastructure IA d’entreprise, les abonnements Workers Paid (disponibles à partir de 5 USD/mois, avec des paliers supérieurs selon le volume) et les plans Business à 250 USD/mois (~340 CAD) ou Enterprise suivront naturellement.
Soyons clairs : l’open source ici n’est pas de la philanthropie. C’est une stratégie de distribution. Ça ne veut pas dire que c’est mauvais pour toi en tant qu’utilisateur, ça veut dire que tu comprends l’alignement d’intérêts avant de bâtir ta stack dessus.
À qui ça s’adresse et dans quels contextes
| Profil d'équipe | Utilité de Cloudflare OS | Niveau de maturité requis |
|---|---|---|
| Équipe DevOps avec expérience Workers | Très élevée : peut déployer et adapter les modules directement | Intermédiaire à avancé |
| Équipe IA/ML sans background infra réseau | Modérée : bénéficie des patterns, mais doit apprendre l'écosystème Cloudflare | Intermédiaire |
| Startup early-stage sans infra existante | Variable : bonne base si tu pars de zéro, mais beaucoup à absorber | Selon les ressources disponibles |
| Grande entreprise avec stack AWS/GCP établie | Faible à court terme : l'intégration avec une infra existante demande du travail | Avancé requis pour l'intégration |
| Équipe sécurité qui veut auditer l'infra IA | Très élevée : l'open source est précisément ce qu'ils cherchent | Tous niveaux (audit possible sans déploiement) |
Le profil idéal, c’est une équipe technique qui déploie déjà du code sur Cloudflare Workers et qui veut ajouter des agents IA sans construire toute la plomberie elle-même. Si tu as déjà ton infrastructure dans Workers, l’adoption de Cloudflare OS est un chemin relativement naturel. Par contre, si ta stack actuelle est entièrement sur AWS ou GCP, le saut est plus important. Tu ne vas pas migrer ton infrastructure réseau parce qu’un projet GitHub semble intéressant. L’intégration hybride est possible, mais elle demande du travail d’adaptation que le projet ne résout pas pour toi.
Ce qu’on trouve sur le dépôt GitHub
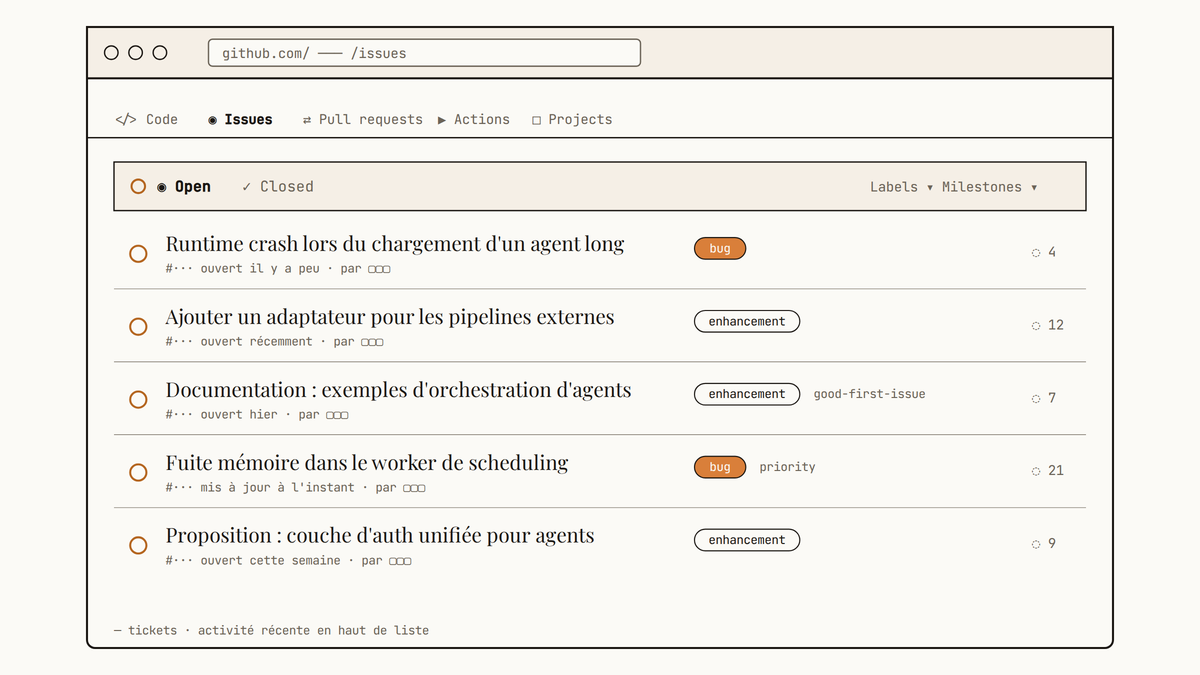
Le dépôt est organisé en modules séparés, chacun avec sa propre documentation. On trouve des exemples de configuration, des scripts de déploiement, et des tests. La qualité de la documentation varie d’un module à l’autre, ce qui est normal pour un projet en phase active de développement. Les issues GitHub sont ouvertes et actives. C’est un bon signe : ça veut dire que les mainteneurs répondent et que la communauté commence à s’impliquer. C’est aussi là que tu trouveras les vraies limites du projet, pas dans le README.
Le CONTRIBUTING.md existe et est détaillé. Les conventions de code sont définies, le processus de PR est documenté. C’est le signal qu’ils ont l’intention de maintenir un projet sérieux, pas de juste mettre du code sur GitHub pour l’annonce de presse. Ce qu’on ne trouve pas encore : des intégrations officielles avec des orchestrateurs d’agents populaires. Si ton équipe utilise déjà LangChain, AutoGen ou un framework maison, tu vas devoir construire les ponts toi-même pour l’instant.
Les limites et questions en suspens
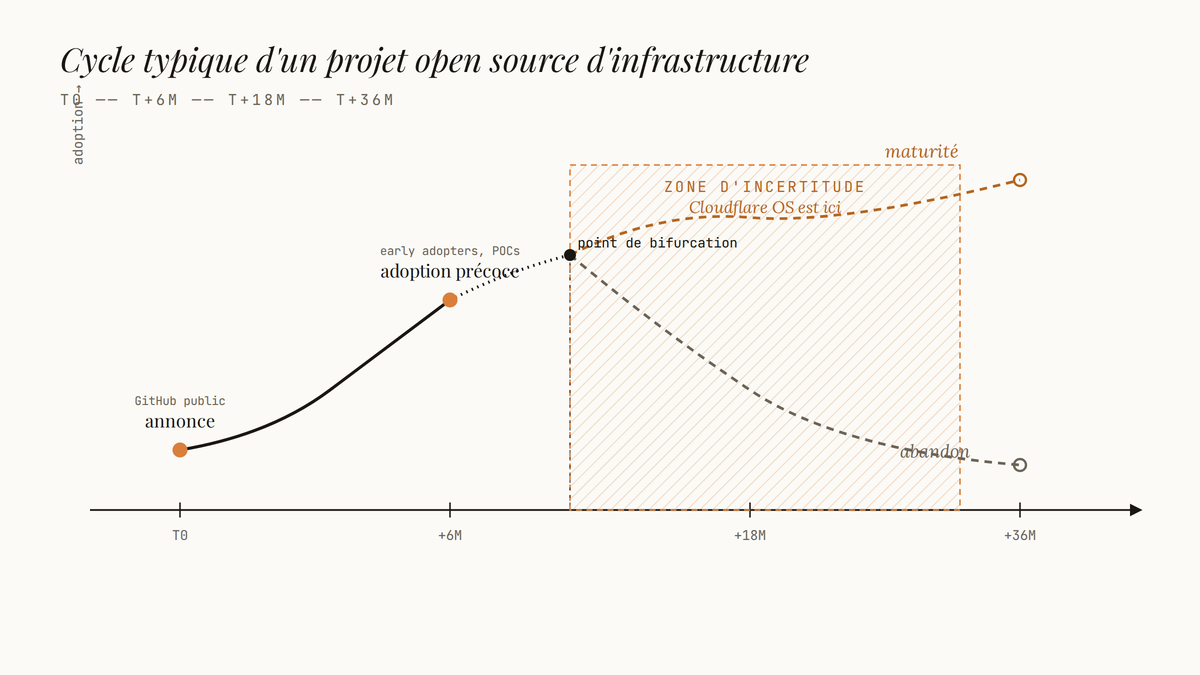
OK check ça. Plusieurs questions restent sans réponse claire dans la documentation actuelle, et elles méritent d’être posées avant d’intégrer ce projet dans une stack de production. La maturité du projet. Un dépôt GitHub récent avec une bonne documentation n’est pas la même chose qu’un projet battle-tested. La question pour une équipe entreprise : est-ce que ce module a survécu à une charge de production réelle? Les benchmarks de performance en contexte d’entreprise ne sont pas encore publics. Le support à long terme. Cloudflare a une longue liste de projets open source actifs, et aussi des projets qui ont ralenti après l’annonce initiale. Quelle est la garantie de maintenance sur Cloudflare OS dans un an ou deux? Pour l’instant, la réponse honnête est : on ne sait pas. C’est Cloudflare, donc la crédibilité organisationnelle est là, mais ce n’est pas un engagement contractuel.
La dépendance à l’écosystème Cloudflare. Même si le projet est open source, les composants de stockage (R2) et d’exécution (Workers) créent une dépendance fonctionnelle à Cloudflare comme fournisseur. Ce n’est pas du vendor lock-in au sens où tu ne peux pas partir, mais migrer hors de l’écosystème demandera des efforts. C’est un choix à faire consciemment. L’intégration avec les stacks d’entreprise existantes. Les environnements d’entreprise ont des contraintes spécifiques : SSO, politiques réseau, conformité réglementaire, intégrations avec des systèmes internes legacy. Cloudflare OS ne prétend pas résoudre tout ça. C’est aux équipes techniques d’adapter.
Le hic : Cloudflare OS est un point de départ solide, pas une solution clé en main. Les équipes qui s’attendent à un déploiement sans friction vont déchanter. Celles qui ont la capacité de contribuer et d’adapter vont en tirer de la valeur réelle.
Ce que ça signifie pour les équipes tech en entreprise
Regarde ben. Cloudflare OS s’inscrit dans une tendance plus large et importante à comprendre : les fournisseurs d’infrastructure réseau deviennent des acteurs IA à part entière. Ce n’est pas Cloudflare qui fait exception, c’est la direction que prend l’industrie. Pendant longtemps, l’infrastructure réseau et l’infrastructure IA étaient deux domaines séparés. Des équipes différentes, des fournisseurs différents, des cycles d’achat différents. Ce modèle est en train de se décomposer. Quand ton réseau CDN peut exécuter des agents IA à la périphérie, la frontière entre « infra réseau » et « infra IA » disparaît.
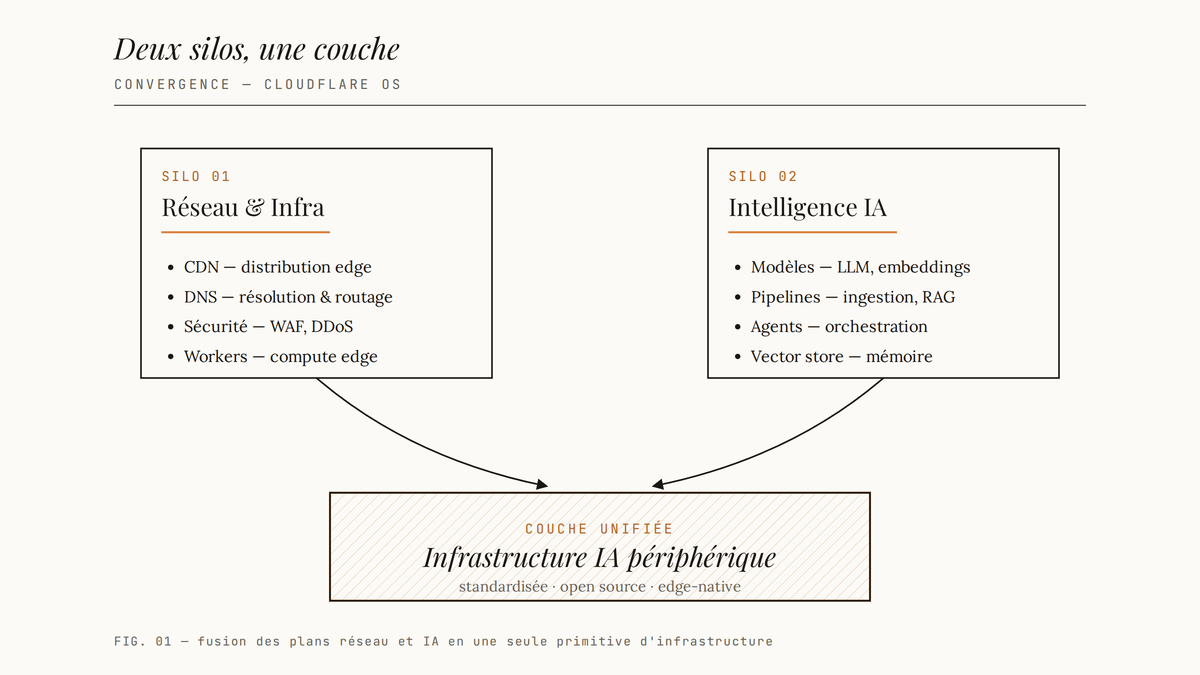
Pour les équipes tech en entreprise, la décision pratique à court terme n’est probablement pas « est-ce qu’on adopte Cloudflare OS maintenant? » La décision, c’est « est-ce qu’on alloue du temps à une personne pour évaluer le projet sérieusement? » La réponse à cette deuxième question est probablement oui, surtout si tu as déjà une présence dans l’écosystème Cloudflare. Les équipes qui ne sont pas encore sur Cloudflare Workers ont moins d’urgence. Mais elles ont intérêt à surveiller l’évolution du projet sur les prochains mois. Si l’écosystème de contributions grossit et que des intégrations avec des frameworks d’agents populaires apparaissent, la proposition de valeur va changer rapidement.
| Horizon temporel | Action recommandée | Pourquoi |
|---|---|---|
| Court terme (maintenant) | Lire le README et les issues GitHub ouvertes | Évaluer la maturité réelle sans engagement |
| Court terme (si Workers existant) | Déployer un module non-critique en environnement de test | Valider la compatibilité avec ta stack |
| Moyen terme | Suivre les releases et la croissance des contributions | La trajectoire du projet dit plus que l'état actuel |
| Long terme | Réévaluer l'intégration complète selon l'évolution de l'écosystème | L'alignement avec d'autres outils va déterminer la valeur réelle |
La tendance de fond mérite d’être intégrée dans ta réflexion stratégique : les entreprises qui vont construire leurs pipelines IA sur des couches standardisées et auditables vont avoir un avantage opérationnel sur celles qui construisent du custom chaque fois. Cloudflare OS est un pari sur cette vision. Si le pari est bon, adopter tôt a de la valeur. Si le projet ralentit, tu auras perdu du temps de configuration. Le risque est asymétrique selon la taille de ton organisation.
Soyons directs sur les coûts. Le projet open source lui-même ne coûte rien. Les services Cloudflare sous-jacents, oui. Les plans Workers Paid commencent à 5 USD/mois (~7 CAD) avec des paliers selon le volume d’exécutions. Pour des pipelines IA actifs, le coût réel va dépendre de ton usage, et tu dois le modéliser avant de commencer à construire sérieusement en production.
Conclusion : verdict et prochaines étapes
Cloudflare OS est un projet sérieux porté par une organisation qui a les moyens de le maintenir. L’approche open source est la bonne pour ce type d’infrastructure d’entreprise : tu ne vas pas mettre ta stack IA sur du code que tu ne peux pas auditer. Le positionnement de Cloudflare comme acteur d’infrastructure IA plutôt que simple CDN est cohérent avec où va l’industrie. Sauf que le projet est jeune. Les questions sur la maturité en production, le support à long terme et les intégrations avec des stacks non-Cloudflare restent réelles. Ce n’est pas une critique du projet, c’est la réalité d’un écosystème en construction. Si tu es déjà sur Workers : va lire le dépôt GitHub cette semaine. Identifie un module que tu pourrais tester sans risque. Donne-toi un mois pour évaluer. Si tu n’es pas sur Cloudflare : mets le projet sur ta liste de surveillance. Réévalue dans quelques mois quand la communauté de contributions sera plus visible. Le verdict de fond : c’est le bon projet au bon moment, porté par le bon acteur. Mais « bon » ne veut pas dire « prêt pour toi maintenant ». C’est toi qui dois répondre à cette question pour ton contexte.
Quoi faire maintenant : Ouvre le dépôt GitHub de Cloudflare OS. Lis les issues ouvertes avant le README. Les problèmes rapportés par les premiers utilisateurs te diront ce que le marketing ne te dit pas. C’est toujours là que se trouve la vérité sur un projet open source en phase précoce. Fin de l’histoire.
Check tes courriels.
Lien à cliquer pour confirmer ton abonnement.
Texte par David Cyr