OK check ça. DeepSeek vient de lancer deux nouveaux modèles texte le 24 avril 2026 : V4 Flash (284B paramètres) et V4 Pro (1,6T paramètres). Fenêtre de contexte à 1M tokens, licence MIT, prix qui font mal aux concurrents occidentaux. Voilà ce que tu dois savoir avant de décider si ça change quelque chose dans ton stack. Ce que tu vas apprendre :
- Les specs techniques exactes de V4 Flash et V4 Pro
- La comparaison de prix avec GPT-5.4 (le ratio va surprendre)
- Ce que la licence MIT change concrètement pour ton usage
- Pour qui chaque modèle a du sens en 2026
Deux nouveaux modèles texte de DeepSeek : ce qu’on sait
DeepSeek, la société chinoise fondée en 2023 comme spin-off du fonds quantitatif High-Flyer, a bâti sa réputation sur un ratio performance/coût agressif. DeepSeek-R1, sorti en 2025, avait déjà secoué l’industrie. V4 Flash et V4 Pro continuent dans la même direction, mais avec une fenêtre de contexte qui change la catégorie dans laquelle ils jouent. Ces deux modèles sont texte seulement. Pas de vision, pas de génération d’images, pas de traitement audio. C’est important de le noter tout de suite : si ton workflow dépend d’entrées multimodales, tu restes chez Gemini 2.5 Pro ou Claude pour l’instant.
La date de release officielle : 24 avril 2026. Et DeepSeek a également confirmé que les anciens aliases deepseek-chat et deepseek-reasoner seront retirés le 24 juillet 2026 à 15:59 UTC. Si tu utilises ces aliases dans ton code, mets-les à jour avant cette date.
Specs techniques : paramètres, fenêtre de contexte et architecture
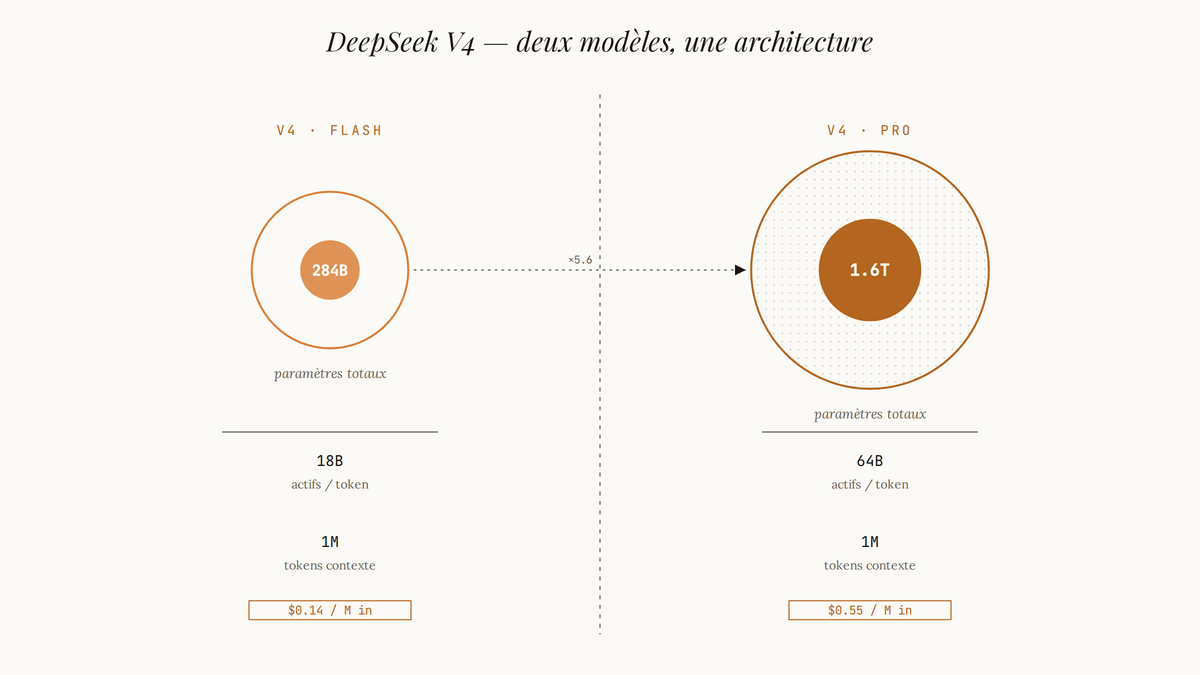
V4 Flash affiche 284B paramètres totaux, mais seulement environ 13B paramètres actifs par token. V4 Pro monte à 1,6T paramètres totaux avec environ 49B actifs par token. Cette distinction est clé : l’architecture Mixture of Experts (MoE) permet d’avoir un modèle massif sur le papier sans activer l’ensemble du réseau à chaque inférence. C’est ce qui rend les prix viables.
La fenêtre de contexte est identique pour les deux : 1M tokens en input, avec un maximum de 384K tokens en output. C’est la même classe que Gemini 2.5 Pro pour le traitement de longs documents. Ça veut dire concrètement que tu peux charger une codebase entière, un rapport d’audit complet, ou des semaines de transcriptions sans découper.
La fenêtre à 1M tokens n’est pas un gadget. C’est la différence entre « je dois orchestrer manuellement mes chunks » et « je lance une seule requête et je récupère une analyse cohérente ». La concurrence maximale varie : V4 Flash supporte jusqu’à 2 500 requêtes simultanées, V4 Pro se limite à 500. Pour une application en production avec du volume, Flash est l’option naturelle. Pro est pour les cas où la qualité prime sur le débit.
| Spec | V4 Flash | V4 Pro |
|---|---|---|
| Paramètres totaux | 284B | 1,6T |
| Params actifs/token | ~13B | ~49B |
| Fenêtre de contexte | 1M tokens | 1M tokens |
| Max output | 384K tokens | 384K tokens |
| Concurrence max | 2 500 req/s | 500 req/s |
Tarifs API : comparaison directe avec GPT-5.4 et les autres
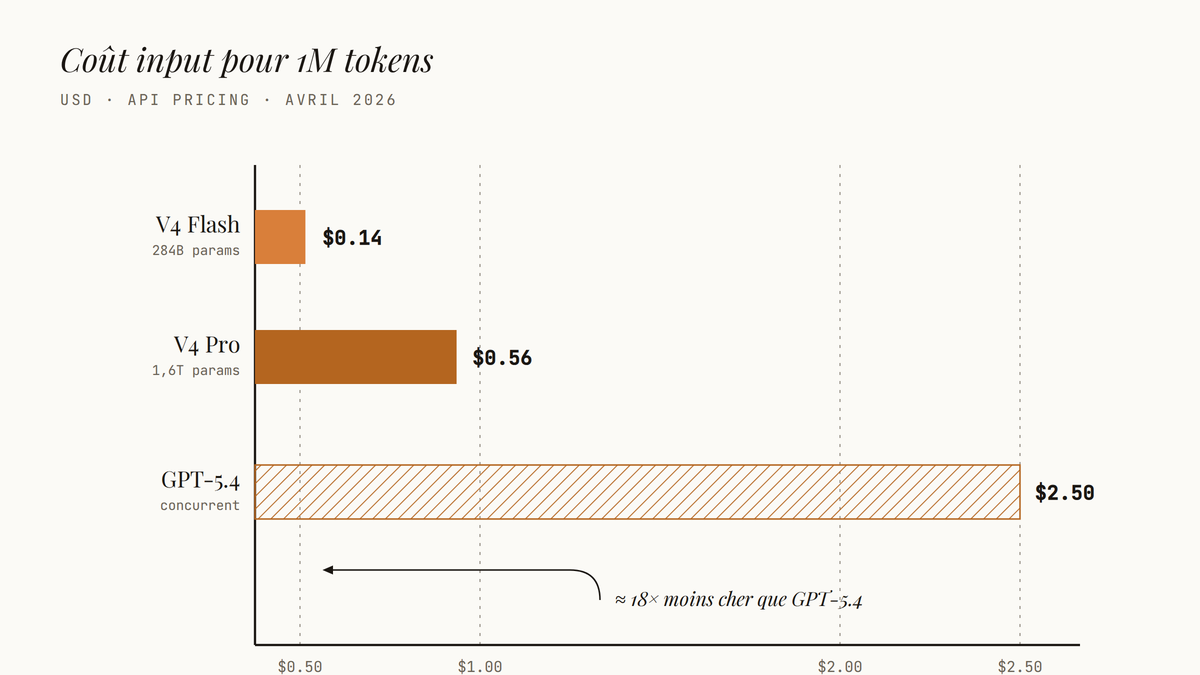
C’est ici que ça devient intéressant. V4 Flash : 0,14 USD par million de tokens en input (standard), 0,0028 USD/M en cache, et 0,28 USD/M en output. V4 Pro : 0,435 USD/M en input (standard), 0,003625 USD/M en cache, et 0,87 USD/M en output. Les deux prix sont en USD.
Le ratio input entre GPT-5.4 et V4 Flash est de 17,9×. Sur l’output, le ratio monte à 53,6×. Ce n’est pas une optimisation marginale. C’est un ordre de magnitude différent. Pour un pipeline qui envoie et reçoit beaucoup de tokens, la différence de coût mensuel peut justifier à elle seule une migration.
Pour un Québécois qui paie son API en USD : 0,14 USD/M tokens Flash, ça représente environ 0,19 CAD au taux actuel. GPT-5.4 à 2,50 USD/M, c’est environ 3,45 CAD/M. Le calcul est brutal. Le cache agressif de DeepSeek mérite attention. À 0,0028 USD/M en input caché pour Flash, les requêtes répétées avec un contexte stable coûtent presque rien. Si tu travailles avec un system prompt long ou un document de référence chargé à chaque session, le cache change ton économie complètement.
Licence MIT : ce que ça implique concrètement
DeepSeek publie ses modèles en open-weight sur Hugging Face depuis ses familles V2/V3. V4 Flash et V4 Pro arrivent également sous licence MIT. Concrètement : tu peux utiliser les poids pour des applications commerciales, modifier l’architecture, fine-tuner sur tes données, redistribuer. Pas de frais de licence cachés, pas de restriction sur le secteur d’activité. La licence MIT est la plus permissive du spectre open source. Elle diffère des licences « open » qui imposent des restrictions sur l’usage commercial ou qui exigent que les dérivés restent open source. Ici, tu prends les poids, tu fais ce que tu veux, tu attribues simplement l’origine.
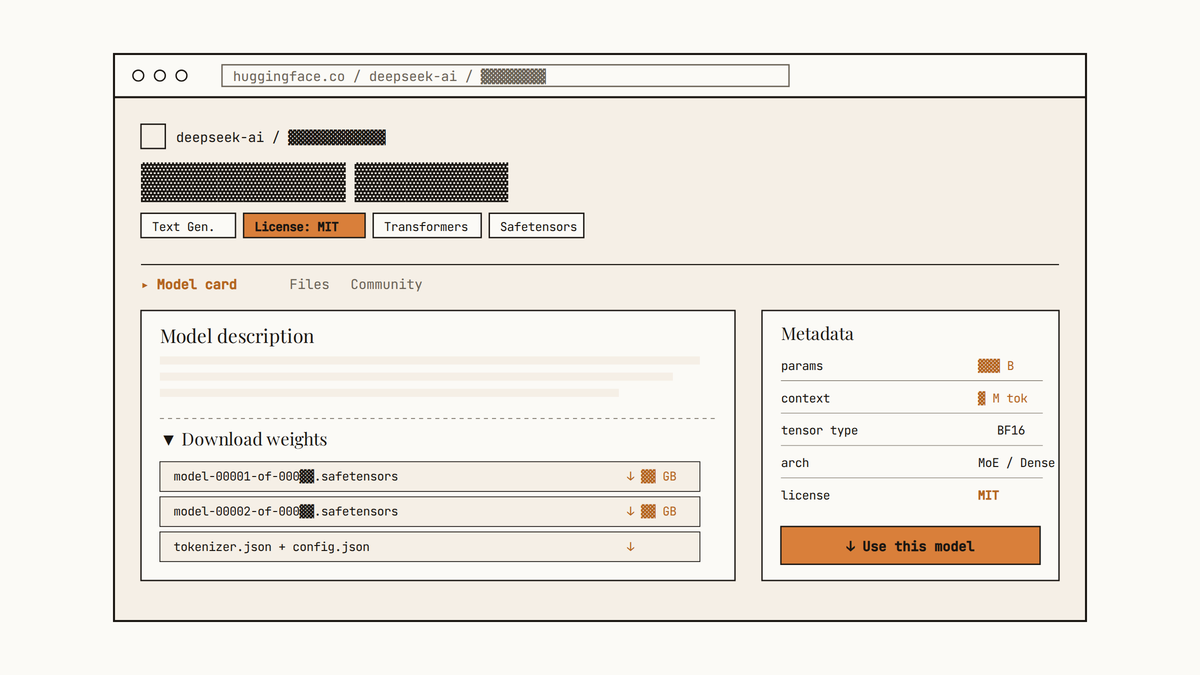
Ça ouvre deux cas d’usage que l’API seule n’offre pas. Premier cas : le déploiement on-premise. Si tu travailles avec des données sensibles (juridique, santé, RH), tu peux héberger le modèle sur ton infrastructure et ne jamais envoyer de données à des serveurs tiers. Deuxième cas : le fine-tuning ciblé. Tu peux adapter le modèle à ton domaine sans attendre que le fournisseur offre cette option dans son API. Le hic sur la licence MIT : elle s’applique aux poids publiés par DeepSeek sur Hugging Face. L’API DeepSeek reste un service distinct avec ses propres conditions d’utilisation. Si tu accèdes aux modèles via l’API plutôt qu’en téléchargeant les poids, tu es soumis aux ToS de l’API, pas seulement à la MIT. Lis les deux.
Pour qui ces modèles ont du sens
V4 Flash est fait pour le volume. Si tu gères un pipeline qui traite un grand nombre de documents, résumés, extractions structurées, ou classifications, Flash te donne un contexte long à un prix qui permet d’absorber le coût à l’échelle. La concurrence élevée (2 500 requêtes simultanées) confirme son positionnement batch et production. V4 Pro est fait pour les cas où la qualité du raisonnement prime. Avec ~49B paramètres actifs par token, il a accès à plus de « capacité » à chaque inférence. Pour des tâches complexes : analyse juridique, synthèse de recherche, génération de code sur des problèmes architecturaux. Le prix plus élevé reste nettement en dessous des alternatives fermées comparables.
| Cas d'usage | Modèle recommandé | Raison principale |
|---|---|---|
| Traitement batch de documents | V4 Flash | Prix et concurrence élevée |
| Analyse complexe ponctuelle | V4 Pro | Capacité de raisonnement accrue |
| Déploiement on-premise | V4 Flash ou V4 Pro (poids MIT) | Licence permet l'hébergement local |
| Contexte long (rapports, codebases) | Flash ou Pro selon budget | 1M tokens disponible sur les deux |
| Application multimodale | Ni l'un ni l'autre | Texte seulement |
Si tu travailles sur des données confidentielles et que l’API d’un fournisseur étranger pose un problème de conformité, la licence MIT et l’accès aux poids changent l’équation. Tu peux déployer localement sans dépendre du service cloud de DeepSeek.
Ce qu’on ne sait pas encore
La performance réelle sur des benchmarks indépendants reste à confirmer. DeepSeek publie ses propres évaluations, mais les comparaisons tierces sur des tâches spécifiques au contexte québécois ou francophone prennent du temps à accumuler. Pour l’instant, les specs sont solides sur le papier ; l’expérience d’usage à grande échelle se construira dans les prochaines semaines. La disponibilité régionale de l’API et la latence hors d’Asie méritent aussi d’être testées avant de migrer un pipeline critique. Un prix plus bas ne compense pas une latence qui brise ton SLA. Enfin, la question de la durabilité du modèle économique de DeepSeek reste ouverte. Des prix aussi agressifs posent la question de la trajectoire à long terme. Est-ce que ça reste à ces niveaux? Est-ce que la qualité de service tient à volume? C’est à surveiller.
Note de suivi important : les aliases
deepseek-chatetdeepseek-reasonerdisparaissent le 24 juillet 2026 à 15:59 UTC. Si tu as des intégrations existantes, planifie la migration maintenant, pas le 23 juillet.
Verdict et prochaine étape
V4 Flash à 0,14 USD/M tokens input avec 1M de contexte et licence MIT : c’est une option sérieuse pour tout pipeline texte à volume. V4 Pro à 0,435 USD/M pour les cas complexes reste plus abordable que les alternatives fermées comparables. La licence MIT est le vrai joker pour les équipes avec des contraintes de conformité. Ce que tu fais maintenant : si tu as un cas d’usage texte, tu testes Flash sur un batch représentatif de ta charge réelle. Tu mesures la qualité sur ton domaine (pas sur des benchmarks génériques), tu calcules ton coût réel avec le cache, et tu compares. Si ça passe la barre qualité, le reste du calcul est simple. Le verdict de la Taverne est clair : DeepSeek continue de mettre la pression là où ça fait mal, et cette fois avec une fenêtre de contexte qui les place dans la même conversation que les modèles haut de gamme. Texte seulement, mais à ce prix, c’est difficile d’ignorer. C’est tout.
Check tes courriels.
Lien à cliquer pour confirmer ton abonnement.
Texte par David Cyr