Si ton agent de code passe du temps à scraper Stack Overflow et des repos GitHub à la volée pour trouver du contexte, tu jettes des crédits par la fenêtre. Firecrawl vient de lancer un index de plus de 70 millions d’artéfacts techniques pré-indexés, directement consommables via API. Ce que tu vas apprendre :
- Ce qu’est le Firecrawl Developer Index et d’où ça vient
- Ce que couvrent les 70M+ artéfacts concrètement
- Comment intégrer l’index dans un pipeline agent ou RAG existant
- Pourquoi le recall de 63%@10 est le chiffre à retenir
- Les limites honnêtes et les questions qui restent sans réponse
En bref
5 choses à savoir
- 70M+ artéfacts indexés : issues GitHub, pull requests, READMEs, docs officielles et agent skills, curatés pour les contextes de codage.
- Aucune clé API requise pour démarrer : tu peux interroger l’index sans friction initiale pour tester.
- Recall@10 de 63% : sur un benchmark de 1 179 requêtes développeur, l’index retrouve la bonne ressource dans les 10 premiers résultats 63% du temps, soit environ 10% de mieux que le meilleur concurrent externe testé.
- Endpoint dédié :
/v2/search/developers’intègre dans les pipelines LangChain, LlamaIndex ou agents custom sans réécriture majeure. - C’est le 12e lancement de Firecrawl : l’équipe (fondée en 2024, sortie de Y Combinator batch S24) continue d’empiler des surfaces pour les builders d’agents.
Dans le détail
Ce qu’est le Firecrawl Developer Index
Firecrawl, c’est à la base un outil de web scraping qui retourne du Markdown propre, optimisé pour les LLMs. Tu pointes une URL, tu reçois du contenu structuré prêt à injecter dans un prompt. Ça, c’était la brique de départ. Le Developer Index, c’est l’étape d’après. Au lieu de scraper à la volée à chaque requête d’agent, Firecrawl a pré-crawlé, nettoyé et indexé une masse massive de contenu technique. L’idée : ton agent interroge un index stable plutôt que le web chaotique.
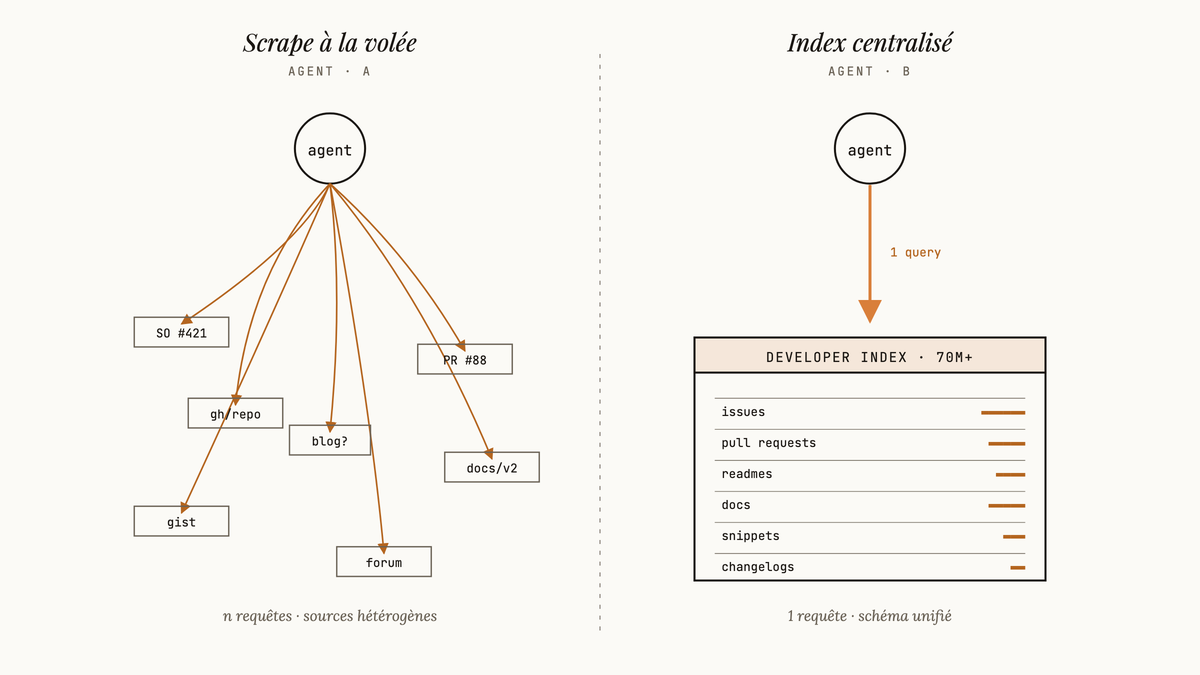
C’est le 12e lancement officiel de Firecrawl sur Product Hunt, avec une note de 5.0/5 sur 15 avis et plus de 3 100 followers du produit. La communauté qui suit ça, c’est clairement des builders d’agents, pas des utilisateurs grand public.
70 millions d’artéfacts : ce que ça couvre vraiment
Les 70M+ artéfacts couvrent cinq types de contenus : issues GitHub, pull requests, READMEs, documentation officielle et agent skills. C’est volontairement orienté codage, pas usage général.
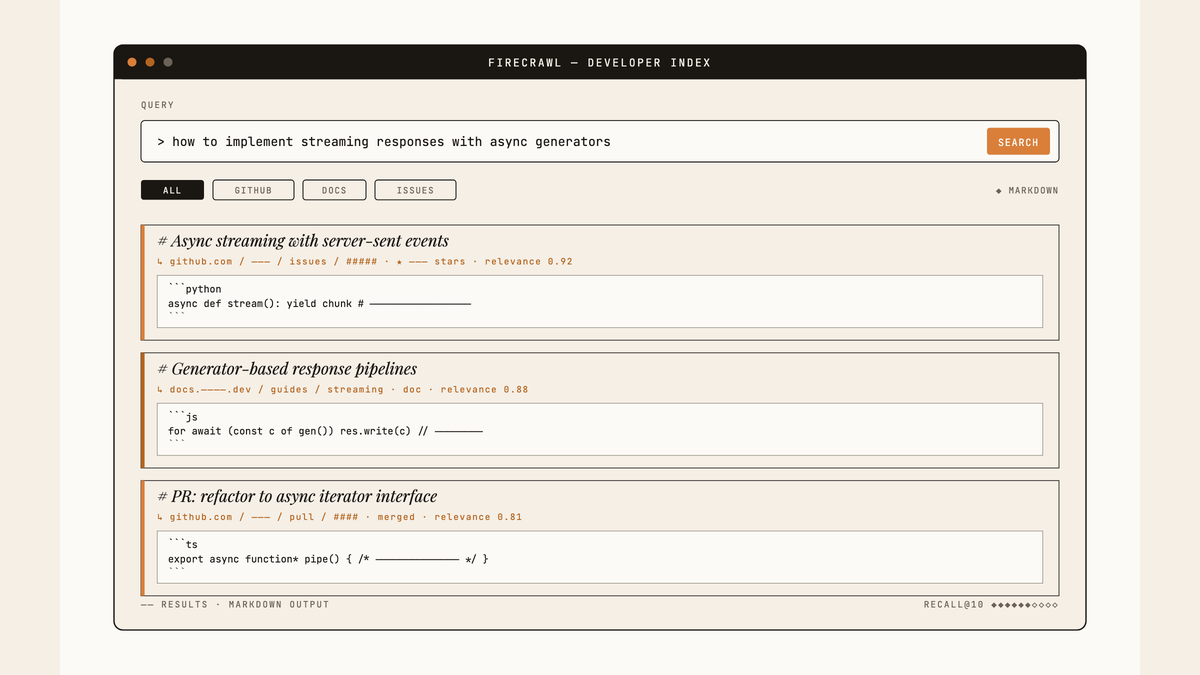
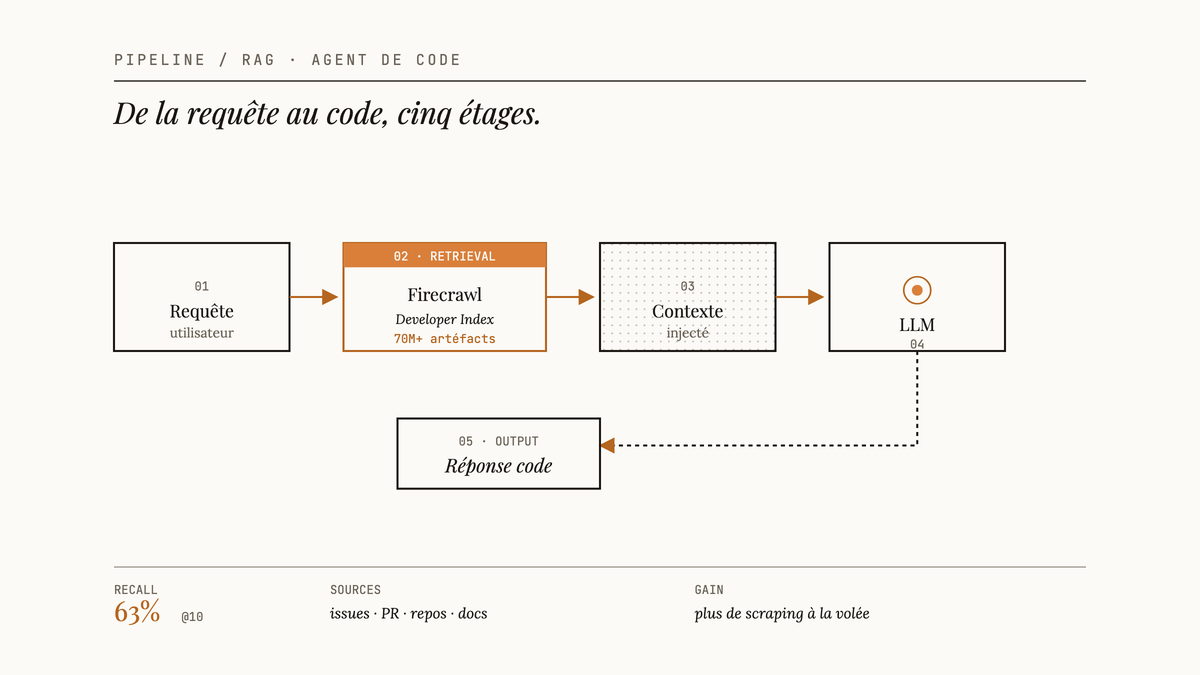
Le recall@10 à 63% veut dire quoi en pratique ? Sur dix résultats retournés par l’index pour une requête donnée, la bonne réponse technique est présente 63% du temps. Ce n’est pas parfait. Mais c’est environ 10% au-dessus du meilleur alternative externe testée dans le même benchmark sur 1 179 requêtes développeur. Ce n’est pas une couverture universelle : les 70 millions d’artéfacts couvrent certains langages et frameworks plus que d’autres. La documentation qui change souvent (librairies en développement rapide, projets à faible adoption) risque d’être sous-représentée ou datée. À vérifier au cas par cas selon ton stack.
Comment l’index s’intègre dans un pipeline d’agent de code
L’accès se fait via l’endpoint /v2/search/developer. Tu envoies une requête texte décrivant ton besoin technique, tu reçois des artéfacts pertinents en Markdown propre. Ça s’adapte directement au schéma d’un retriever LangChain ou LlamaIndex.
# Exemple conceptuel d'intégration
import requests
response = requests.post(
"https://api.firecrawl.dev/v2/search/developer",
json={"query": "how to handle rate limiting in FastAPI"},
headers={"Authorization": "Bearer YOUR_API_KEY"}
)
artifacts = response.json()["results"]
# → liste de Markdown propre, prêts à injecter dans ton prompt
Pour un agent custom qui n’utilise pas de framework RAG standardisé, c’est aussi simple : tu interroges l’endpoint, tu sérialises les résultats dans ton contexte, tu appelles ton LLM. La friction est quasi nulle parce que le contenu arrive déjà formaté pour les modèles de langage.
Avantage concret pour les pipelines RAG : tu n’as plus besoin de gérer un scraper, un chunker, un embedder et un vector store pour la couche de récupération de docs techniques. L’index prend en charge cette partie. Tu te concentres sur la logique de ton agent.
Pourquoi c’est pertinent pour les développeurs qui bâtissent avec des LLMs
Le problème classique quand tu bâtis un agent de codage : les LLMs ont une date limite de connaissance et les APIs, librairies et façons de faire évoluent vite. Passer par l’index donne à l’agent accès à des issues récentes, des PR fusionnées, des docs à jour, sans augmenter la taille du prompt de base.
La curation compte. N’importe qui peut scraper GitHub. Ce que Firecrawl vend ici, c’est un index nettoyé et structuré. Les issues fermées sans résolution, le bruit des bots de dépendances, les README vides : tout ça est censé être filtré. Le benchmark sur 1 179 requêtes développeur donne un signal concret sur la qualité réelle, pas juste sur le volume.
| Critère | Scraping à la volée | Firecrawl Developer Index |
|---|---|---|
| Latence de retrieval | Variable (dépend du site cible) | Stable (index pré-calculé) |
| Fraîcheur des données | Temps réel mais risqué | Indexation périodique (fréquence à confirmer) |
| Format de sortie | HTML brut à parser | Markdown propre pour LLMs |
| Maintenance côté dev | Élevée (gérer scraper, anti-bot) | Quasi-nulle |
| Couverture | Illimitée mais aléatoire | 70M+ artéfacts curatés |
| Recall sur requêtes dev | Non mesuré | 63%@10 (benchmark 1 179 req.) |
Qui est touché
Les limites et questions ouvertes
Soyons clairs. Une note de 5.0/5 sur 15 avis, c’est trop peu d’avis pour être fiable. L’enthousiasme du lancement est réel, mais les retours à froid dans quelques semaines vont être plus instructifs. La fraîcheur des données est la question la plus importante. Firecrawl n’a pas encore publié de calendrier explicite de mise à jour de l’index. Pour un agent qui travaille sur des librairies actives (pense à tout ce qui sort dans l’écosystème Python IA en ce moment), un index statique vieillit vite.
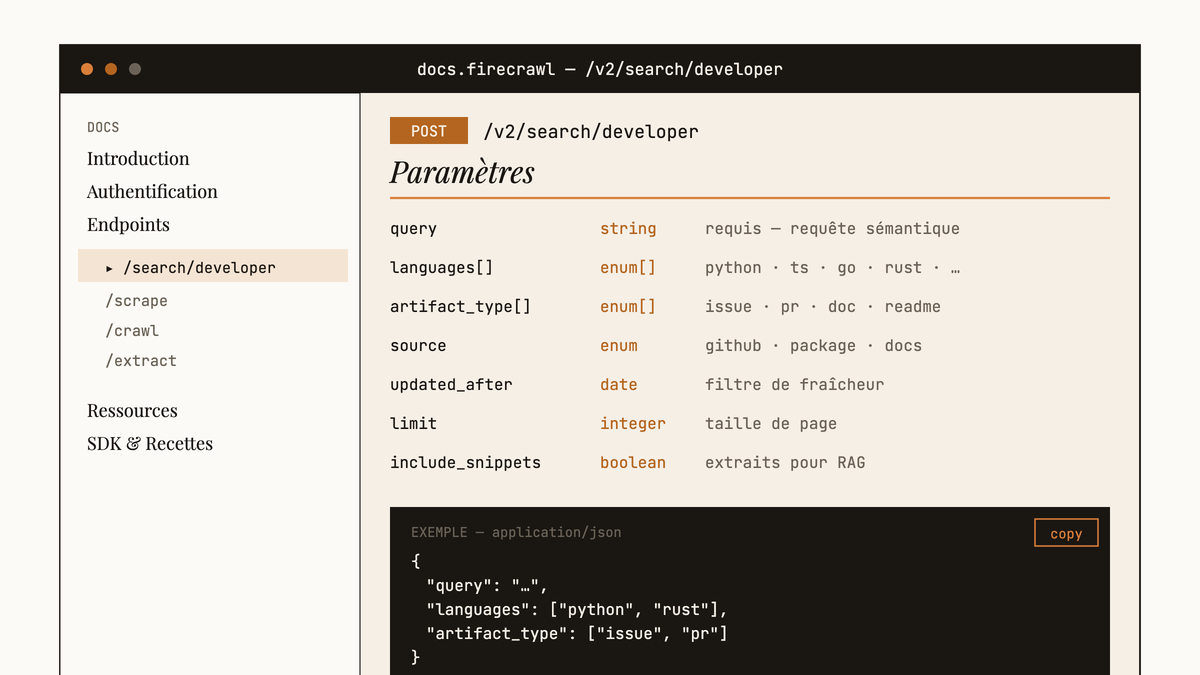
La couverture par langage et framework n’est pas détaillée publiquement. JavaScript et Python sont probablement bien couverts. Ce qui est moins certain : Rust, Elixir, les frameworks plus niche, ou les dépôts privés des projets d’entreprise. Si ton stack est mainstream, tu es probablement bien servi. Si tu travailles sur quelque chose de moins répandu, teste avant de t’engager. La condition d’utilisation commerciale mérite aussi une lecture attentive de la documentation officielle avant d’intégrer ça dans un produit que tu monétises. Le plan gratuit existe, mais les limites de taux et les droits de redistribution du contenu indexé ne sont pas toujours évidents à première lecture.
| Plan | Prix | Crédits inclus |
|---|---|---|
| Free | 0 $US/mois | Selon doc officielle |
| Hobby | 19 $US/mois | 3 000 crédits |
| Standard | 99 $US/mois | À vérifier dans la doc |
| Scale | 399 $US/mois | À vérifier dans la doc |
| Enterprise | Sur mesure | Illimité ou selon entente |
Comment commencer à l’utiliser
Pas de clé API requise pour démarrer. C’est intentionnel : Firecrawl veut que tu testes l’index sans friction. Tu vas sur la documentation de l’endpoint /v2/search/developer, tu envoies une requête test, tu vois ce que ça retourne pour ton cas d’usage.
La démarche logique : prends une requête que ton agent pose souvent, compare ce que l’index retourne versus ce que ton pipeline actuel récupère. Si la qualité est au rendez-vous sur tes cas d’usage prioritaires, l’intégration dans LangChain ou LlamaIndex prend peu de temps avec un retriever custom.
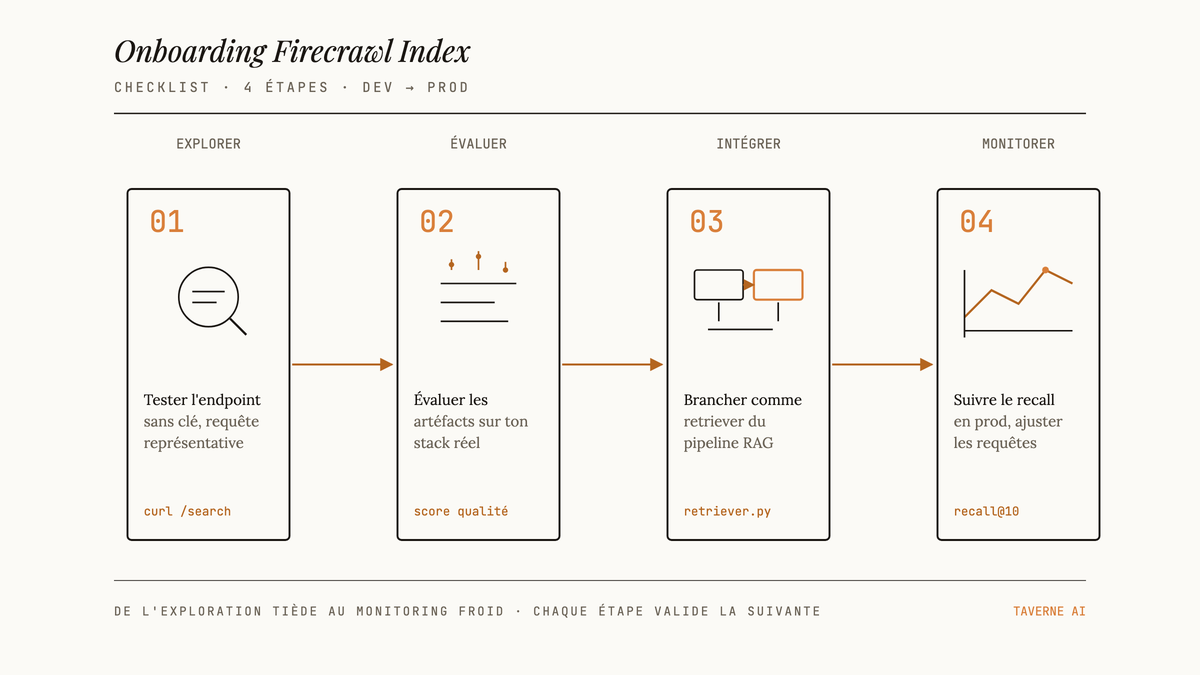
Pour les équipes qui bâtissent des agents de codage plus complexes, l’approche raisonnable est de commencer avec le plan Free pour valider la pertinence sur ton domaine, puis de monter vers Hobby (19 $US/mois, avec 3 000 crédits inclus) une fois que tu as confirmé que l’index couvre bien tes librairies et frameworks cibles.
Verdict
Le Firecrawl Developer Index est une brique utile si tu bâtis des agents de codage et que tu veux externaliser la couche de retrieval de documentation technique. Les 70M+ artéfacts curatés avec un recall@10 de 63% sur un benchmark réel de 1 179 requêtes développeur, c’est un signal sérieux. Ce n’est pas juste un dump de web scraping. Le hic : la fraîcheur des données reste la boîte noire du lancement. Un index qui ne se met pas à jour fréquemment devient un fardeau plutôt qu’un atout dans un écosystème qui bouge aussi vite que l’IA en ce moment. Pose la question directement à l’équipe Firecrawl avant de construire dessus pour un usage de production critique. Pour qui c’est fait : les devs qui bâtissent des pipelines RAG orientés code, les équipes qui veulent réduire la complexité opérationnelle de leur stack de retrieval, et ceux qui construisent des agents autonomes qui ont besoin de contexte technique fiable. Pour qui c’est prématuré : les équipes sur des stacks niche ou des librairies très récentes, et ceux qui ont besoin de garanties explicites sur la fréquence de mise à jour et les droits d’utilisation commerciale. Teste l’endpoint sur tes requêtes réelles. Aucune clé API requise pour commencer. Tu sauras en quelques minutes si ça couvre ton cas. Pas plus compliqué que ça.
Check tes courriels.
Lien à cliquer pour confirmer ton abonnement.
Texte par David Cyr