Google vient d’annoncer trois nouveaux modèles Gemini. Pas une mise à jour cosmétique : une stratégie explicite pour dominer l’orchestration d’agents IA autonomes à grande échelle. Le message est clair. Google ne veut plus juste être dans la course des modèles de langage génériques. Il veut devenir l’infrastructure sur laquelle les agents IA de demain tournent. Ce que tu vas apprendre :
- Quels sont les trois nouveaux modèles Gemini et à quoi chacun sert
- Pourquoi Google fait ce virage vers les agents autonomes maintenant
- Ce que ça change concrètement si tu développes avec l’écosystème Google
- Les limites réelles à surveiller avant de partir à fond dans cet écosystème
Ce que Google a annoncé
Arrête. Ce n’est pas une annonce de modèle de plus dans le flux. Google présente ici trois modèles distincts, chacun avec un positionnement délibéré dans un pipeline d’agents. L’idée de fond : les cas d’usage entreprise ont besoin de systèmes où plusieurs agents collaborent, se coordonnent, et agissent de façon autonome sur des tâches longues et complexes. Un seul modèle généraliste ne suffit plus. Ces trois modèles visent explicitement les développeurs et les équipes techniques, avec des intégrations profondes dans Google Cloud. Ce n’est pas un produit grand public : c’est une couche d’infrastructure.
Un point important à saisir dès le départ : Google ne positionne pas ces modèles contre ChatGPT ou Claude dans le sens grand public. La cible, c’est le développeur qui construit un système multi-agents pour automatiser des workflows complexes en entreprise.
Les trois modèles Gemini en détail
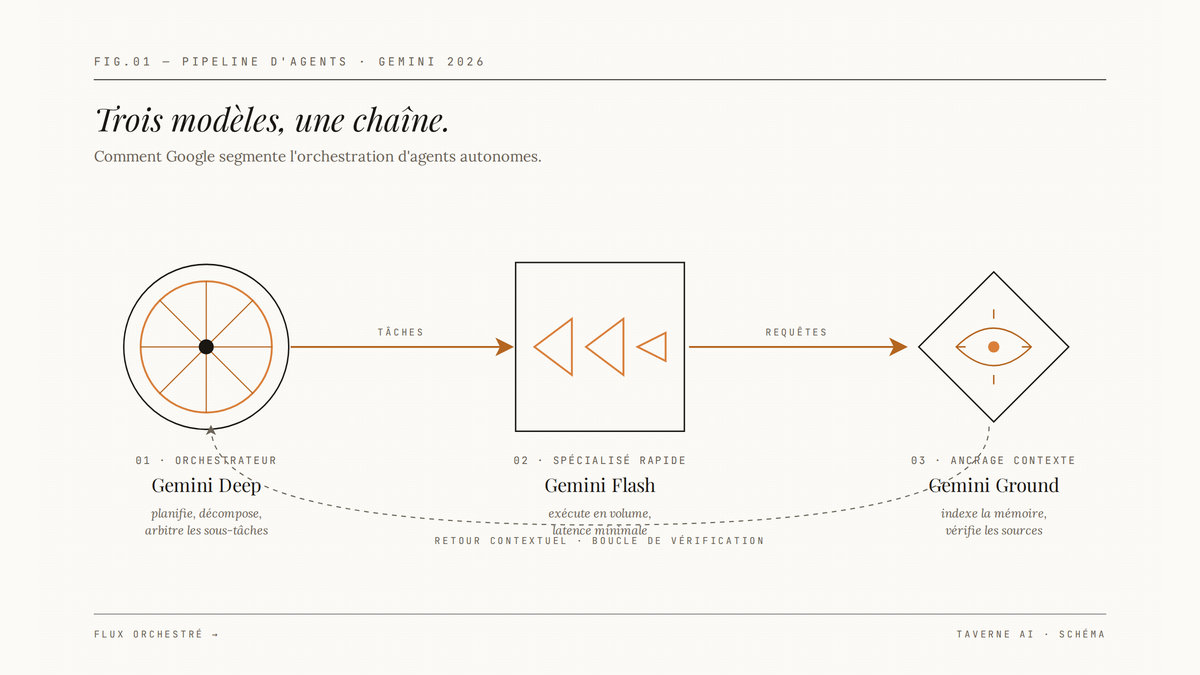
Le premier modèle joue le rôle d’orchestrateur. Il coordonne, planifie, délègue aux agents spécialisés, et synthétise les résultats. C’est le chef d’orchestre du pipeline. Le deuxième modèle est optimisé pour la rapidité sur des tâches spécialisées répétitives. Il est fait pour tourner à volume élevé : des milliers d’appels dans un workflow automatisé, sans que la latence tue l’expérience. Le troisième cible l’ancrage contextuel et la mémoire longue. C’est le modèle qui garde le fil sur des projets longs, maintient la cohérence entre plusieurs sessions, et évite que le système « oublie » ce qui a été établi.
| Modèle | Rôle principal | Usage typique |
|---|---|---|
| Orchestrateur | Planification et coordination | Décision, délégation entre agents |
| Modèle rapide | Exécution spécialisée à volume | Tâches répétitives, appels fréquents |
| Modèle contextuel | Mémoire longue et cohérence | Projets longs, continuité entre sessions |
Google affirme que ces modèles sont significativement plus rapides que leurs prédécesseurs. Qualitativement, sur des tâches d’orchestration, la latence perçue serait nettement réduite. Les chiffres de benchmarks officiels sont à consulter dans la documentation Google Cloud directement : on ne va pas reproduire des valeurs sans les avoir vérifiées.
Pourquoi Google mise sur les agents autonomes
Le truc c’est que le marché a changé. Les LLMs génériques sont devenus des commodités. OpenAI, Anthropic, Mistral, Meta : tout le monde livre un modèle compétent. La différenciation ne se gagne plus sur le modèle seul. Elle se gagne sur l’infrastructure qui les fait tourner ensemble. Google a un avantage structurel ici : Google Cloud, Vertex AI, Google Workspace, et maintenant ces trois modèles. Si tu construis déjà dans cet écosystème, l’intégration est native. Tu ne patchs pas un modèle externe dans ton pipeline : tu utilises des briques qui sont conçues pour fonctionner ensemble. C’est aussi une réponse directe à Microsoft, qui pousse Copilot Studio et Azure OpenAI Service dans la même direction. La guerre de l’IA enterprise de 2026, c’est une guerre d’écosystème.
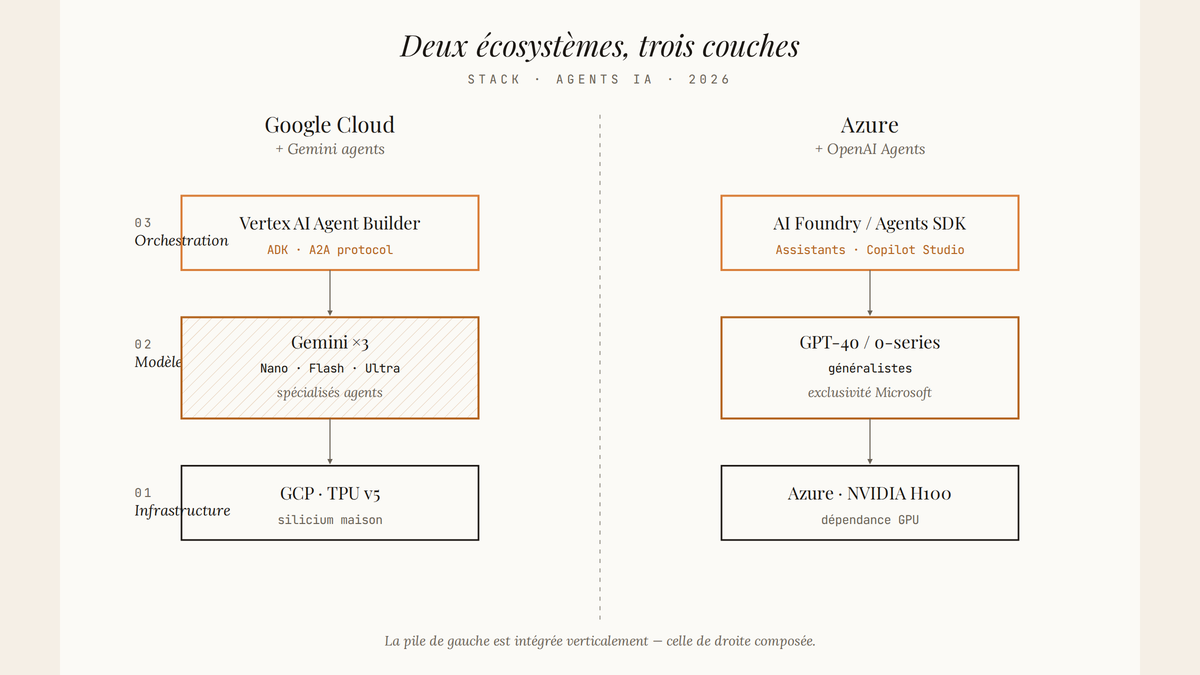
Bon, fait que… le virage est stratégique autant que technique. Google ne peut pas se permettre de perdre les grandes entreprises au profit de Microsoft sur les cas d’usage agents. Ce lancement, c’est un signal à l’industrie autant qu’une release de produit.
Ce que ça change concrètement pour les développeurs
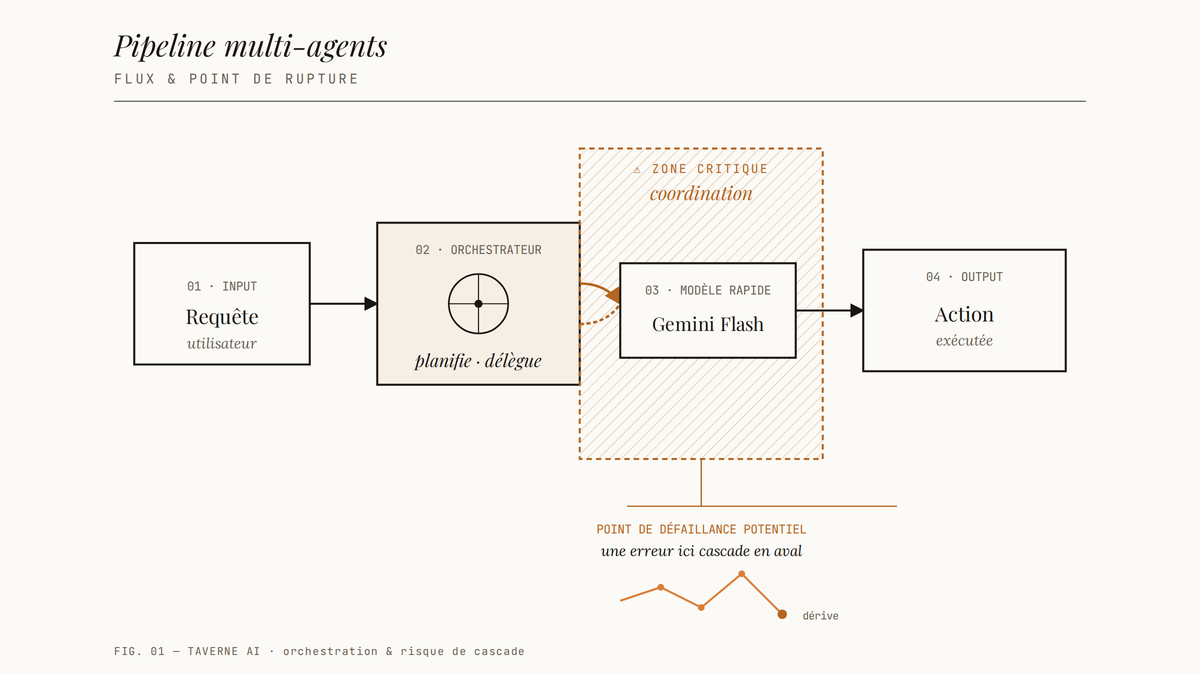
Si tu travailles avec Vertex AI ou que tu construis sur Google Cloud, c’est une mise à jour que tu vas sentir dans tes workflows. L’accès à ces modèles se fait via les APIs Google Cloud habituelles. Pas de nouveau compte à créer, pas d’onboarding séparé : tu appelles les endpoints, tu choisis ton modèle selon le rôle dans ton pipeline, tu configures. Pour les équipes qui ont déjà investi dans cet écosystème, le coût de migration est minimal. La partie qui demande le plus d’attention, c’est la conception du pipeline lui-même. Quel agent fait quoi, comment ils se passent l’information, comment tu gères les erreurs quand un agent sous-jacent plante. Ce n’est pas une question de modèle : c’est une question d’architecture. Sur le plan des coûts, Google Cloud facture à l’usage selon ton plan et ton volume d’appels API. Pour les individus ou les petites équipes qui veulent tester l’écosystème Gemini sans engagement, il existe un plan gratuit (0 $US/mois) avec accès limité. Le plan AI Plus coûte 8 $US/mois et le plan AI Pro monte à 20 $US/mois. Pour les déploiements enterprise avec les fonctions avancées, le plan AI Ultra est à 255 $US/mois. Les coûts d’appels API pour des volumes de production sont à calculer séparément selon ton usage réel : consulte la grille tarifaire Vertex AI directement.
Limites et questions ouvertes
Soyons clairs : on est à l’annonce. Pas à l’évaluation terrain avec six mois de production derrière. La première limite à surveiller, c’est la performance en conditions réelles. Les démonstrations de pipelines multi-agents sont toujours impressionnantes dans un contexte contrôlé. Ce qui est moins clair, c’est comment ces systèmes se comportent quand les données sont sales, les instructions ambiguës, et les sous-tâches échouent de façon inattendue. La sse, ça se valide dans le temps. Deuxième enjeu : le lock-in. Si tu construis ton pipeline d’agents sur des briques Google propriétaires, migrer vers une autre infrastructure dans six mois devient coûteux. Ce n’est pas un défaut en soi : c’est un calcul à faire consciemment avant de partir.
Troisième question ouverte : la comparaison honnête avec les offres concurrentes. OpenAI a poussé ses Agents SDK et Anthropic a son approche avec Claude sur des tâches d’orchestration. Est-ce que les modèles Gemini gagnent sur tous les types de tâches? Non. Est-ce qu’il y a des cas où ils excellent spécifiquement? Probablement. Sans benchmarks indépendants sur des tâches représentatives de ta situation, la réponse honnête c’est : à tester.
Le hic ultime : les architectures multi-agents sont complexes à déboguer. Quand ça plante dans un pipeline à trois modèles, trouver où le problème a émergé n’est pas trivial. Les outils de monitoring et d’observabilité pour les agents IA sont encore jeunes.
Notre verdict rapide
Google frappe un coup stratégique cohérent. Trois modèles spécialisés au lieu d’un généraliste fourre-tout, intégrés dans un écosystème Cloud déjà en place : c’est une proposition sérieuse pour les équipes techniques qui construisent des systèmes d’agents à grande échelle. C’est pertinent pour toi si :
- Tu développes déjà sur Google Cloud ou Vertex AI
- Tu construis des pipelines d’automatisation complexes en entreprise
- Tu as besoin d’un écosystème intégré plutôt qu’une collection d’outils patchés ensemble C’est moins pertinent si :
- Tu veux tester rapidement un outil sans engagement d’infrastructure
- Ta priorité est un modèle généraliste pour des tâches variées non-agentiques
- Tu construis quelque chose de petit et la latence ou le volume ne sont pas des enjeux Pis là tu te dis probablement : est-ce que Google tient vraiment ses promesses cette fois? La réponse honnête, c’est qu’on le saura dans quelques mois quand les équipes en production auront du feedback réel à partager. Ce que je vais faire : surveiller les retours des développeurs qui vont tester ça sur des workloads réels et revenir avec une évaluation terrain. En attendant, si tu es dans l’écosystème Google, vaut la peine de lire la documentation et de faire tourner un prototype.
Quoi faire maintenant : Si tu construis des agents IA sur Google Cloud, lis la doc Vertex AI sur ces trois nouveaux modèles avant de conclure que ça ne te concerne pas. Si tu es ailleurs (AWS, Azure, standalone), surveille les benchmarks indépendants avant de changer quoi que ce soit. Le bon écosystème dépend de ton architecture, pas de l’annonce la plus récente. Fin de l’histoire.
Check tes courriels.
Lien à cliquer pour confirmer ton abonnement.
Texte par David Cyr